- Завершил миграцию текстов прошлых публикаций с 2011 года (включая транскрибации видео-выступлений) из архива в Дропбокс в транспортную шину в Протоне (папка PROD, контексты text-ship и record-sync, как раз оказалось удобно отделить текстовые публикации от видео):
- перенесённые заметки обрели целостную хронологию по датам, удобно искать;
- разделены на тексты и видео, удобно;
- единый YAML-frontmatter тоже удобен даже глазу визуально, в будущем будет удобен LLM для индексации (исправить его впоследствии);
- оценил масштаб созданного за предыдущие годы - около 120 текстов разного качества, но наполненные ключевыми тезисами, эволюция которых видна в течение времени (я это знаю, но теперь это видно);
- на эти заметки можно ссылаться и внутри них можно ссылаться;
- обнаружил при миграции четыре куска текста, которые не были опубликованы и тянут на полноценные заметки, так как содержат много хороших тезисов;
- простым перечитыванием ранее опубликованных текстов можно восстановить в голове множество хороших тезисов, за которые не стыдно, и из которых таким образом восстановить набор заметок для графа знаний. Тезисов реально множество качественных, и целесообразно провести какую-то работу по перечитыванию хотя бы для оценки количества и качества тезисов. Из них там уже можно скомпилировать книгу. Или поручить эту работу LLM. Это на подумать на будущее; как минимум, хороший кусок качественных материалов собственного производства в графе знаний появился, который лежал бы либо в архиве, либо протухал в голове;
- вспомним про кучу цитат в архиве под тегом #quotes, до которых когда-то дойдут руки, так как это начатый инфометаболизм и тот же wip, и в сумме может получиться отличный граф знаний. Вообще получить бы реверс-инжинирингом “вечнозелёные” заметки, как бы восстановить такт А синтеза, который за публикациями не виден, было бы очень неплохо. Как разберусь с контуром инфометаболизма, задать вопрос LLM, как это сделать правильным методом, и нужно ли это делать.
-
Черновики как рабочие продукты практики мышления письмом - это аналог атомарных “вечнозелёных” заметок в Обсидиан, образующих граф знаний и связывающий образовательные заметки в куски текста. Просто у Церена, чтобы не усложнять для начинающих изучать практики саморазвития, два такта синтеза - А и Б, которые предложила мне LLM, были сразу объединены в один этап создания черновика; в то время как в более точном методе должна быть выделен такт А создания графа знаний из “вечнозелёных” заметок в Обсидиан (или картотеки Лумана), который ценен сам по себе и создаётся так, как если бы никаких статей и готовых текстовых артефактов из него отгружать не планировалось, и такт Б отбирания из графа нужных заметок и собирания их в черновик будущего готового продукта. Результатом что стадии создания черновика из образовательных заметок в практике мышления письмом, что двух тактов синтеза в инфометаболизме становится полуфабрикат, почти готовый к отчуждению, прообраз будущего текста. И остаётся его только перевести на стадию PROD, отредактировать с LLM и опубликовать (что в заготовке, что в публикации, неважно - это всё стадия публикации, отчуждения текста в мир, его отгрузки). Получается, что я “нырнул” с инфометаболизмом глубже, и LLM при проектировании моей архитектуры разделила правильно контексты потребления, двухтактового синтеза и производства текста. Но - если бы я не был знаком с первой версией инфометаболизма в виде практики мышления письмом, предложенная LLM архитектура показалась бы сверхсложной, а так я просто усовершенствовал уже имеющуюся, которую попробовал и обрёл в которой мастерство на уровне умения. И теперь у меня развитие, смена метода. И вот настало время прочитать Ahrens. How to take smart notes, чтобы раз и навсегда разобраться с собственным контуром инфометаболизма, чтобы он заработал на полную. Причём инфометаболизм (и это тоже более важное усовершенствование LLM) определяется в моей архитектуре “концом”, выдачей готового продукта, а не “началом”, потреблением информации, что вытекало из практики мышления письмом. Таким образом, усовершенствование в двух моментах: разделение синтеза на два явных такта с графом знаний как промежуточным рабочим продуктом первого такта; план по производству готовых артефактов определяет потребление качественной информации на входе, а не факт её наличия на складе/в архиве.
-
Изменил в закладках браузера Хром содержимое папок ACQ и SYN, так как синтезв Обсидиан; в клубе больше нет черновиков, а есть исключительно заготовки (а они точно не являются рабочим продуктом стадии синтеза, а являются рабочим продуктом стадии производства готовых артефактов).
-
Понял, что в контексте SYN не может быть никакого архива. Наличие в контексте синтеза того, что кажется архивом - это обычный WIP, который “подвешен” в непереработанном состоянии, либо ошибочно сложенные туда заметки. В контексте синтеза существуют два такта - А и Б:
- цель первого такта - из раздробленных на мелкие кусочки потреблённых текстов (внешний рабочий продукт практики систематического медленного чтения или мышления проговариванием - образовательных заметок, которые имеют срок действия не более семи дней, потом они протухают, так как уже непонятно, почему мозг решил записать эту мысль; но если она важна, она придёт потом не раз, поэтому протухшие заметки можно без сожаления удалить; ценности в них нет, более того, возможно, она пришла тебе в голову с опозданием на 20 лет, что означает, что в ней тем более уже нет ценности, хотя кажется, что есть) создать “вечнозелёные”, с почти неограниченным сроком годности, атомарные заметки графа знаний, связанные с другими заметками и отражающими связи между нейронными связями в моём мозгу;
- граф знаний является промежуточным внутренним продуктом контекста синтеза, самоценным, так как это ядро знаний, из которого извлекаются под запрос любые будущие готовые артефакты, в которые избирательно из ядра отбираются нужные заметки (в этом секрет “дьявольской производительности” Лумана, потому что когда есть ядро, генерация готовых продуктов похожа на производство отпечатков с набранного типографским шрифтом текста, с той лишь разницей, что перед каждым новым отпечатком в исходный набор вносятся некоторые изменения, не всегда архитектурные и быстро; поэтому “отпечатки” такого ядра, которые для внешнего наблюдателя выглядят как новые уникальные тексты (так и есть), а для автора являются лишь “отпечатком” быстро пересобранных в нужную структуру заметок ядра, рождаются с высокой скоростью; без ядра этот процесс шёл бы мучительно из головы, но заметки точно так же выбирались бы автором из ядра, с той лишь разницей, что ядро и заметки существовали бы не в виде линкованного графа заметок, а в виде густой сетки нейронных связей, которые были бы не видны, и по которой приходилось бы путешествовать автору, сидя перед листом бумаги или текстовым документом на экране, в котором мучительно рождались бы строки и абзацы);
- второй такт и рождает черновик будущего готового текстового артефакта, и создаётся он быстрым отбором нужных заметок (они визуализированы в графе) через видимые между ними связи (и тут главное будет удержаться от того, чтобы не отобрать лишнее, так как всё кажется уместным и полезным; у меня есть такая проблема, точнее была 10 лет назад, поэтому первые тексты были длиннющими по 30 тыс. знаков и пытались объяснить всё, чтобы раскрыть конкретную тему.
-
Разобрал видео-сырьё, лежавшее в архиве в syn/acq. Возможно, накопление в этом архиве файлов таки означает, что они должны быть либо разобраны, либо сброшены. В контуре инфометаболизма не может быть архивов. Архив - это либо информация, отобранная из внешнего мира до контекста ACQ (склад) и ещё не ставшая WIP, либо готовые и отгруженные во внешний мир публикации и контент, уже переставшие быть WIP.
-
В мае исполняется ровно год с момента начала моего активного погружения в изучение системного мышления (если считать от видеовстречи с Ц. Цереновым 30 мая 2025 года). Если резюмировать моё развитие за этот год, то путь будет выглядеть следующим образом:
- знакомство с системным подходом и саморазвитием обратило моё внимание на мои методы, включая методы саморазвития в роли ученика;
- внедрение методов саморазвития изменило мои текущие действия, в частности, помогло “расчистить” предыдущие задачи, накопленные за годы, что перестало “отъедать” когнитивный ресурс и высвободило его для других задач развития (в частности, освоение руководств МИМ);
- освоение руководства R1 по распожаризации обратило внимание на понятие WIP;
- знакомство с FPF в рамках освоения руководства по распожаризации привело к активным диалогам с LLM;
- понятие “контекст”, почерпнутое из блога А. Левенчука, привело к созданию с помощью LLM библиотеки моих контекстов, то есть описанию моей архитектуры как деятеля (что можно выразить как “я увидел себя как действующую систему, описание которой затрагивало абсолютно все сферы моей деятельности сверху донизу, от функционирования биологического субстрата” до деятельности по созданию контента");
- главным стал взгляд на себя как на систему создания - набор методов (которые постоянно должны меняться, что и есть суть развития). Тут закольцовывание с главной идеей личного развития: каждый из нас есть набор методов, который он выполняет осознанно или нет, этот набор составляет личную культуру, и если мы хотим изменить результаты в жизни, то это нельзя сделать без того, чтобы не обратить внимание на свои методы и не начать управлять ими осознанно. Это у меня и произошло: я увидел свои методы, описал их, составил архитектуру и начал выполнять их/управлять ими осознанно. Всё это нельзя было бы получить, если бы в голове у меня не было начальных знаний по системному мышлению, а партнёром по мышлению не была бы LLM+FPF, а ежедневная деятельность не управлялась бы набором практик саморазвития;
- побочным результатом создания библиотеки контекстов стало осознание роли экзокортекса как ключевой подсистемы деятеля, поддерживающей SoTA-методы, используемые мной во всех моих контекстах на всех уровнях (я даже не совсем понимаю, как их можно выполнять без экзокортекса - это просто невозможно, особенно если ставится задача работать эффективно, не в режиме “тушения пожаров”). Это я вообще не понимал, и не понимал бы дальше, если бы LLM постоянно не делала на этом акцент, и не описала бы его архитектуру;
- понимание архитектуры экзокортекса и его функций как подсистемы в системе “Деятель” заставило меня взглянуть на собственный экзокортекс и прослезиться, увидя, в каком он стихийно сложившемся состоянии находится, образовавшись за последние 20 лет, с начала систематического чтения неправильными методами, и осознав, что работать на нём по всей моей совокупности методов далее нельзя, и надо его менять. Диалог с LLM на эту тему быстро показал, что менять старое не нужно, проще построить новое правильно с нуля, которое будет поддерживать все нужные мне SoTA-методы нужными функциональными компонентами, а это означает применить системное мышление к проектированию, воплощению и эксплуатации правильного экзокортекса, поддерживающего все мои 21 метод из библиотеки спецификаций;
- было принято решение начать рефакторинг экзокортекса, что потребовало от меня фактически встать в три новые для меня роли - архитектора, сисадмина и инженера по безопасности, о которых я ранее, будучи среднего уровня пользователем, имел весьма смутные представления. Встать в эти роли и выполнять их прикладные методы мне позволила LLM, превращавшая мой поток сознания в стройные рекомендации по архитектуре и рефакторингу экзокортекса. Получался взаимный процесс: я ставил LLM в нужные мне роли промптами, а она уже ставила меня своими ответами, рекомендации из которых я внедрял, и мой экзокортекс стал инкрементально меняться. Без LLM+FPF я бы даже не дошёл до мысли о том, что у меня чудовищный архитектурный долг по экзокортексу, каким должен быть правильный экзокортекс для меня и как перейти от текущего его состояния к правильному. Тут снова отсылка к идее саморазвития: если оно обращало внимание на используемые деятелем методы и требовало их приведения к SoTA-состоянию, то LLM+FPF обратила внимание на экзокортекс, являющийся инструментарием/технологиями, поддерживающим SoTA-методы деятеля, и потребовала его приведения к SoTA-состоянию. Таким образом, я осознал конечное состояние “деятель с SoTA-методами и SoTA-экзокортексом для них”, осознал свою удалённость от этого состояния и прочертил в голове траекторию движения от текущего состояния к желаемому. Ключевыми принципами новой архитектуры экзокортекса стали “нулевое доверие”, независимость от вендоров/брендов/провайдеров, отношение к железу как ко временным терминалам доступа, к софту как алгоритмам, высокая когнитивная нагрузка для входа в контексты для удержания в них и блокировки переключений и другие;
- выполнение прикладных методов для рефакторинга экзокортекса в ролях архитектора, сисадмина и инженера по безопасности, создание их рабочих продуктов пока слепо выполняя рекомендации LLM обратило моё внимание как системного начинающего мыслителя на то, что я не владею прикладными дисциплинами этих методов, без чего нельзя рассчитывать на осознанное качественное их выполнение и в итоге воплощение правильного для меня экзокортекса (будет непонятно, зачем делать ту кучу сложных новых незнакомых трудных вещей в новых ролях, если и без них всё как-то работает). Получение с помощью LLM списка прикладных дисциплин и соответствующей литературы привело к задаче это всё переработать, чтобы обрести осознанную компетентность в прикладных методах для экзокортекса (подсознательно я понимал, что рано или поздно я к этому приду);
- задача переработать нужную литературу под нужные инкременты (что тоже явилось инновацией в контуре инфометаболизма, всю жизнь ошибочно работавшего по модели just in case, который потребовалось - и это тоже было бы невозможно без регулярного акцента LLM на подчинённость входа выходу - перевести на модель just in time, что даётся с трудом, но даётся, так как требует ломки фундаментального культурного паттерна, встроенного как привычка) требует понимания логики работы всего моего контура инфометаболизма, поддержанного экзокортексом после рефакторинга.
- Прочитал первую из зафиксированных за 2025 год заготовок с мыслями за неделю и с удовлетворением отметил, что две из пяти зафиксированных в ней неудовлетворённостей за год устранены:
- разрастающийся бэклог книг и лекций (его больше не существует, так как книги относятся к архиву-складу, а не цеху переработки, как я раньше полагал ошибочно, а все ссылки на лекции “послушать позже” обнулены за год переработкой для очистки совести, процентов десять просто сброшено как ритуальное прослушивание), бэклог задач по потреблению контента жёстко контролируется в контуре инфометаболизма, полностью прекратилось потребление контента из Ютуб;
- отсутствие чёткого понимания своих ролей и проектов (оно есть как минимум в виде библиотеки моих контекстов, а прикладные роли в рабочих проектах приостановлены на время изменения моей архитектуры деятеля и экзокортекса для приведения их к SoTA-состоянию, для чего переведены в контекст STBY);
- что касается развития ИИ, то за год он стал неотъемлемой частью моего экзокортекса как сопроцессор мышления, прочитана книга по ИИ-агентам;
- беспокойство по поводу этатизма, экономического невежества и потестарной культуры исчезло, пришло понимание, что нужно выстраивать свою личную защиту от этого всего приведением архитектуры деятеля/экзокортекса к SoTA-состоянию, и это гораздо продуктивнее, так как лучше способствует личному выживанию в условиях данной культуры, чем ритуальное поглощение контента на этот счёт (которое тоже надо делать правильными методами в контуре инфометаболизма, которых не было), ибо я как деятель и мой экзокортекс - это те системы, на функции/конструкции которых я могу влиять полностью;
- к идее изменения мира в лучшую сторону стал относиться более критически, понимая саму возможность это делать, и делать правильно, но этический вопрос и вопрос конечной цели в свете эволюции всего и изменения ради изменения (что изменение, что отказ от изменения дают в конечном космическом итоге один и тот же результат) встают тут в полный рост. Тут та область, в которой очень сильно помогают знания по культурологии, полученные в 2024 году, которые позволяют трезво оценить необходимость инвестирования времени в производство тех или иных изменений в мире и себе.
-
Не должны ли тексты всех моих публикаций в клубе за истекший год оказаться в Обсидиан в папке PROD? Три из них там уже есть. Ранее LLM давала ответ, что вроде этого делать не нужно, так как ссылаться на них нет потребности. Но надо уточнить этот момент. Но по такому принципу надо напрячься и вспомнить все остальные свои публикации где бы то ни было (журналы по продажам и так далее, Ютуб - это гигантское количество, не хотелось бы туда лезть), чтобы перенести их в Обсидиан с YAML-фронтматтером. Очевидно, что часть публикаций являются ценнейшими “вечнозелёными” заметками, точнее, как если бы они были и на их основании была бы сделана публикация. Как минимум, их ценно иметь в Обсидиане для ссылки. Очевидно, что часть публикаций из клуба придётся дублировать в Обсидиан, LLM предложила алгоритм, добавил заметку для планирования работ.
-
Существование архива внутри операционного цеха обработки информации (ACQ, SYN) является онтологическим противоречием. Архив в этих контекстах невозможен - данная зона оперирует исключительно незавершённым производством (WIP). Если есть нечто, что лежит в этих контекстах без движения (неподвижный, статический массив данных и файлов) и тем самым похоже на архив, то это либо WIP, который я сам от себя замаскировал, чтобы снять когнитивную нагрузку, вызванную разрастанием WIP от моих неправильных неосознаваемых действий, либо это скрытые запасы, также замаскированные под архив, которым место на складе, но которые я упорно храню в цеху. Их надо сдвинуть либо назад в архив/на склад, чтобы они не генерировали беспокойство, либо отгрузить как готовые артефакты, либо просто сбросить.
-
Для понимания принципов работы контура инфометаболизма с позиции теории бережливого производства и теории ограничений, нужно провести жёсткие границы между состояниями информации на входе и на выходе, для чего использовать понятную аналогию “склад сырья/запасов - производственный цех - склад готовой продукции”. Она понятна даже интуитивно, в каком состоянии какие продукты могут находиться в каждом подразделении, пересекая его границы, а какие в принципе не могут.
-
Склад сырья - вне контура метаболизма. Это всё, что отобрано из хаоса внешнего мира как источники ценной информации к потреблению. Факт их отбора из хаоса уже означает приложение когнитивной нагрузки и демонстрацию для самого себя ценности информации в данных источниках как ненулевой для меня на данном этапе жизни (ранее она была нулевой, поэтому этих источников на моём складе и не было). Складом является библиотека книг, например. Главное: информация в источниках на складе не потребляет когнитивный ресурс, так как не является wip, она просто хранится без срока годности, максимум - я о ней осведомлён и могу провести инвентаризацию, а что у меня вообще лежит на складе, а также склад почистить, сделать там уборку (если информация нужная, она найдёт меня тем или иным образом, и источник её окажется на складе; я же ранее добавлял на склад всё, что казалось ценным).
-
Цех инфометаболизма - строго лимитированное по объёму и времени, а также видам рабочих продуктов, пространство. Тут не могут храниться ни запасы сырья, ни готовая продукция - тут могут храниться только полуфабрикаты/wip, и то только в ограниченном количестве и сроке, и то только для того, чтобы быть переработанными в готовую продукцию. Если в цех случайно занесли лишний запас - это мгновенно выявляется и он отправляется обратно на склад. Если в цеху из полуфабриката произведена готовая продукция - она мгновенно покидает пределы цеха и выносится на склад готовой продукции. Это интуитивно понятно даже неспециалисту в производстве.
-
В контексте ACQ: на входе - сырьё со склада (источники информации), на выходе - образовательные заметки со сроком годности не более 7 дней (wip). Если за этот срок образовательная заметка не поступила в переработку, её можно выбрасывать, так как мозг потерял понимание, для чего её сформировал - её ценность равна нулю (ценность не в идее в заметке, а в причине, почему произошёл мыслительный резонанс, в результате чего появилось желание заметку записать). Ценность заметки - в фиксации факта мыслительного резонанса, вызванного столкновением своей текущей картины мира с чужой, в результате которой обнаружилось сомнение в адекватности своей картины мира и появилось желание разобраться, чтобы изменить свою, сделать более верной. Ценность заметки образовательной в том, что она указывает на пробел/проблему в своей картине мира, “дырку”, которую надо закрыть.
-
В контексте SYN: на входе образовательная заметка, на выходе такта А - вечнозелёная заметка, встроенная в граф знаний и линкованная с другими. WIP тут - недоработанная/несвязанная заметка, невстроенная в граф. Встроенные в граф заметки поступают на вход такта Б, на выходе из которого под конкретный запрос собирается черновик будущего готового артефакта. WIP тут может быть только очень “сырой” черновик.
-
В контексте PROD: на входе - черновик, на выходе - отгруженный текстовый артефакт.
-
Склад готовой продукции (read-only) - вне контура метаболизма. Это собрание/архив собственных отчуждённых (и где-то опубликованных/отгруженных в каком-то канале маркетинга) продуктов (текстов, видео, аудио). Свою функцию они выполняют, будучи мной созданные. И мне уже не нужно помнить их содержимое, но нужно помнить о них метаданные (когда и где была конкретная публикация, и как её найти, чтобы, если понадобится, вспомнить, о чём я там писал, и сослаться на нёе, если она имеет ценность до сих пор и не устарела, или повторно использовать переработкой для быстрого создания нового артефакта, заточенного под иной контекст). Весь метаболизм собственно, то есть превращение/переваривание/усвоение чужого/превращение в своё происходил от точки начала потребления источника из архива и завершился в точке отгрузки готового артефакта, создание которого и является единственно возможным доказательством взятых из мира знаний, адекватность которых теперь может быть проверена путём предоставления артефакта на суд аудитории (по обратной связи от которой можно будет сделать вывод о качестве своих знаний и ценности их в данном отчуждённом виде для мира, а также внести корректировки или наметить план развития знаний путём дальнейшего метаболизма). Логично, что метаболизма как процесса не может быть на складе запасов/сырья, ни в архиве готовой продукции (он весь в контекстах ACQ-SYN-PROD, образуя контур инфометаболизма). На складе лежат либо продукты свершившегося метаболизма, либо сырьё для будущего. По аналогии, пока еда не попала в рот и далее в желудок, а лежит в холодильнике, ещё нет никакого метаболизма; после того, как из организма вышли продукты её переработки в твёрдом, жидком и газообразном виде, уже нет никакого метаболизма. Весь метаболизм между двумя этими точками - поеданием и выделением, в нём питательные вещества из внешнего мира становятся частью нашего тела, клеток и запаса веществ.
-
Сырьё для будущего метаболизма хранится у меня сейчас в Гугл диске - это библиотека файлов книг. Логично, что любое другое сырьё для метаболизма должно храниться там же. В Протоне как в транспортной шине, где хранится граф знаний и происходит метаболизм, не может храниться сырьё (а тексты из готовой продукции дублируются для того, чтобы о них помнить и ссылаться). Сырью запрещено попадать в цех просто так, оно не может оказаться в цеху несанкционированно. Удалил папки ACQ/SYN из Дропбокс в принципе, чтобы нельзя было там создать архив по ошибке, их так же не может быть ни в Гугле, ни в папках смартфона, ни на флешке. Складом сырья в моей архитектуре экзокортекса назначается Гугл Драйв, к библиотеке книг в котором перекочевало остальное сырьё из Дропбокс. В Дропбокс перенёс папку с материалами по прошлым ивентам в STBY (роли в них тоже на паузе пока).
-
Список прочитанных книг отнесён к категории навигационных компонентов/индексных узлов, содержащий навигационные метаданные, определено его местонахождение в транспортной шине в папке МЕТА, в которой размещён сгенерированный документ, требующий дальнейшей обработки. В данную же папку и специальную подпапку помещена информация о пройденных курсах Института Хайека со ссылками на видео (в каждый файл нужно будет добавить yaml и почистить от лишнего).
-
Установлен запрет на складирование в папке ACQ (а это может оказаться только транспортная шина Протон). Любой файл, попавший в эту папку (а это могут быть либо уже образовательные заметки или логи чатов, сам источник текста попасть туда не может - читаемая книга, например, лежит на рабочем столе), должен превратиться в вечнозелёную заметку в графе знаний Обсидиан в течение недели, либо удалён как “протухший”, даже если жалко затраченного времени (вот чтобы не было жалко, и надо перерабатывать вовремя, и запрещено накапливать; я эту ошибку постоянно повторяю). Папка ACQ к концу недели должна обнуляться - это тот самый принцип практики систематического медленного чтения и мышления письмом “разбирайте образовательные/исчезающие заметки еженедельно”. У меня же сейчас в ней накоплены два десятка заметок по книгам экзокортекса, АЭШ и логи чатов ИИ по инфометаболизму. Это надо срочно отгружать в клуб/в граф знаний/в инкременты. Апдейт: материалы по АЭШ вынес обратно на склад, чтобы не засоряли цех; в цеху только заметки по книгам прикладных методов экзокортекса; логи чатов ИИ переработаны на неделе под ноль.
-
Сбор сырья/пополнение запасов, и работа со знаниями в контуре инфометаболизма - это разные роли. Пополнение запасов осуществляется в роли снабженца (разгружает книги/ссылки/файлы на склад - я добавляю их в Гугл Драйв), а инженер знаний берёт со склада строго одну новую единицу материала (выгружаю на рабочий стол) и переношу работу с ней в ACQ (в соответствующей папке Протона начинают появляться образовательные заметки, количество которых строго контролируется и не может расти wip), она становится WIP. Потом она становится готовой продукцией, и WIP обнуляется.
-
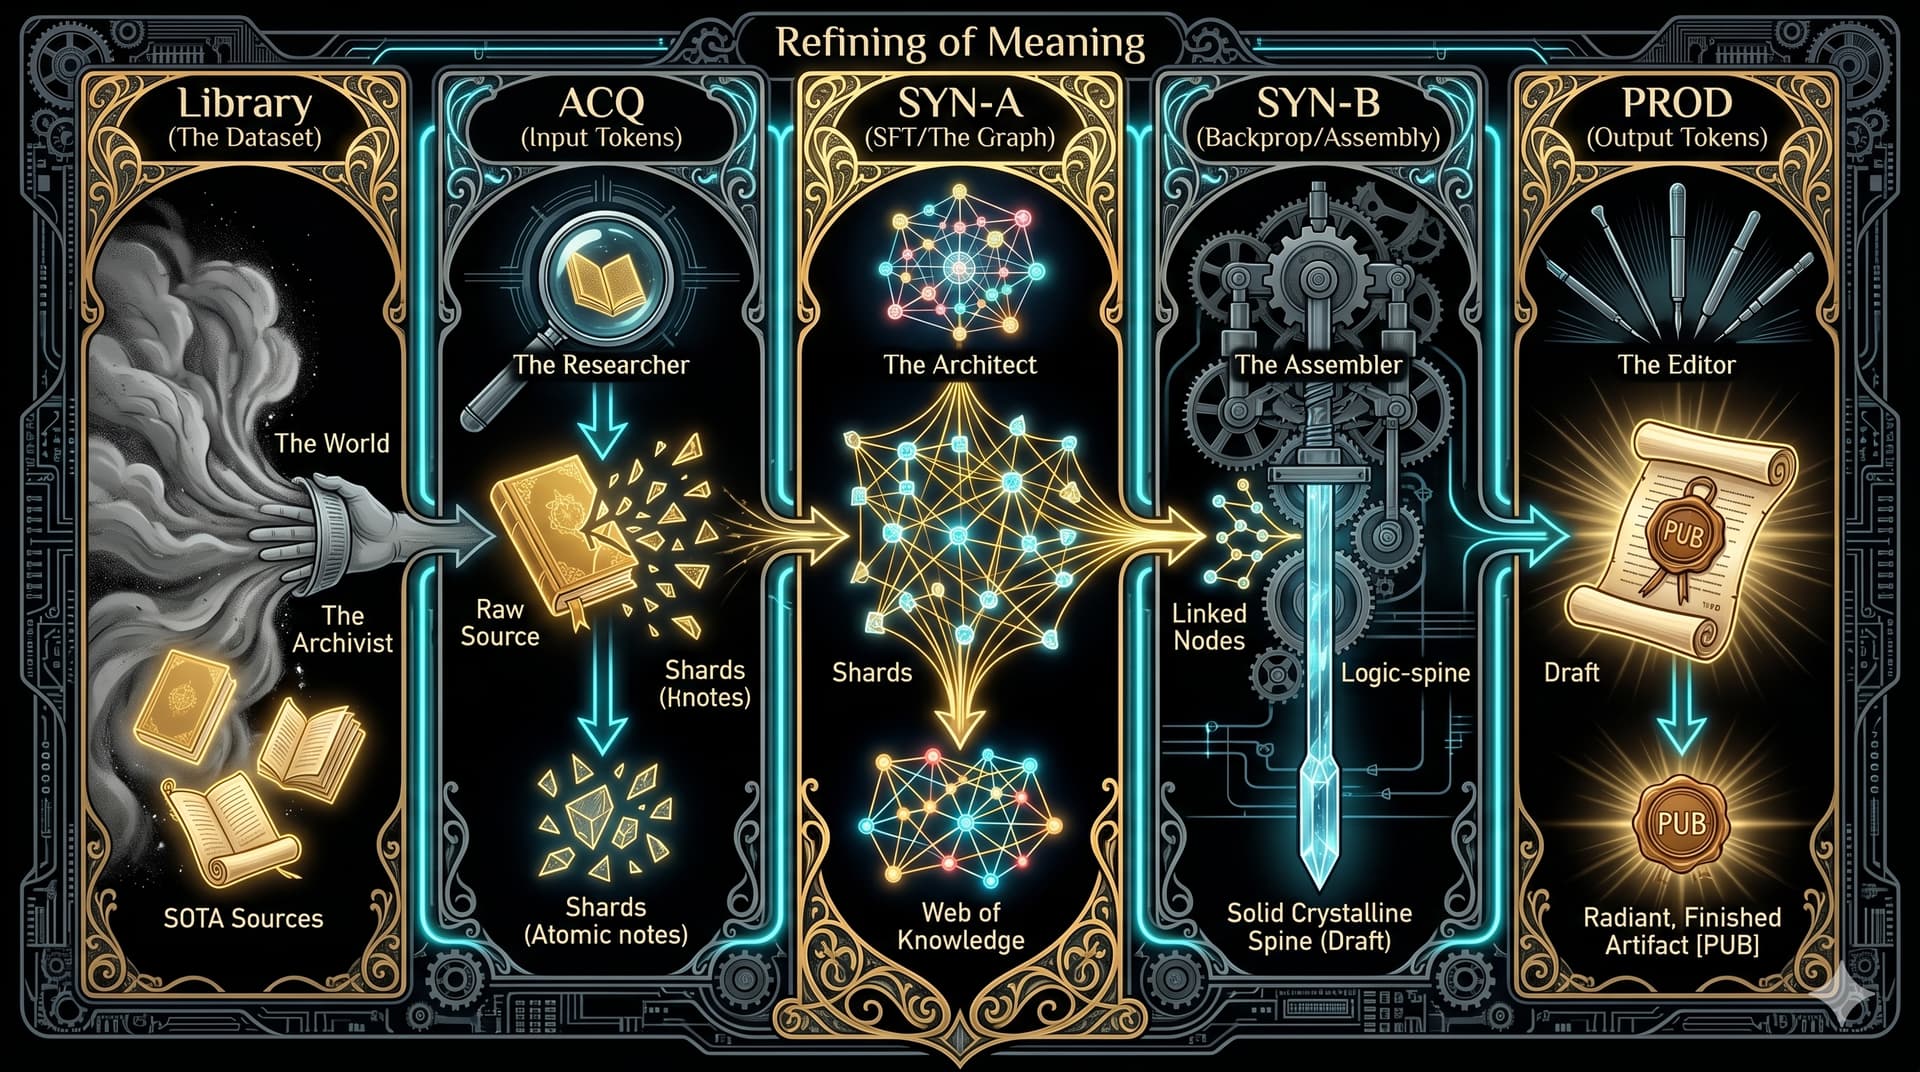
Контур информационного метаболизма, его осознание и рефакторинг является наиболее тяжёлым процессом, так как тут надо ломать фундаментальные за жизнь сформированные неверные привычки, а для начала осознать, что такое SoTA-методы информационного метаболизма в эпоху AI. Но у меня в голове (помогла визуализация) чётко стоит картинка из пяти этапов: склад, acq, syn-a, syn-b, prod/готовая продукция. Центральным является syn-b с графом знаний, крайние находятся в других ресурсах, средние три находятся в транспортной шине.
-
У меня появляются:
- работа со складом (Google Drive), на котором может содержаться только инвентаризованное сырьё, но не могут содержаться полуфабрикаты и готовая продукция, файлы с чувствительной информацией не должны лежать;
- работа с транспортной шиной (Proton Drive), в которой могут содержаться только рабочие документы по архитектуре, полуфабрикаты контура инфометаболизма и дубликаты отгруженных готовых текстовых артефактов, но не может содержаться сырьё, все файлы с чувствительной информацией хранятся там;
- работа с архивом (Dropbox), в котором не может содержаться сырьё и полуфабрикаты, а могут только документы, которым не место в транспортной шине, но к которым может быть обращение в будущем, поэтому удалять их нельзя, файлы с чувствительной информацией не должны лежать;
- работа с бэкапами на “холодном хранении” (Flash Drive).
Это полноценная система, в которой каждому файлу отведено своё место в системе координат “папка” - “место хранения”. Я знаю, где что искать. Структура папок, отражающая 7 уровней, 10 макроконтекстов и 21 контекст моей деятельности, едина везде. Транспортная шина зашифрована, недоступна провайдеру, доступна с любого временного терминала и неуничтожима при сохранности мастер-пароля. Если Протон откажет, есть её бэкап на флешке, обновляемый еженедельно. В принципе, по каждому месту хранения нужно бы составить рабочий документ с описанием регламента его использования (если это уже не описано в спецификации экзокортекса). Неплохой результат к годовщине регистрации в клубе МИМ, о чём сегодня прилетел соответствующий бэйдж. Он был бы невозможен без знакомства с системным мышлением. Если бы это знакомство состоялось раньше, то и данная система появилась бы раньше, а так я жил в состоянии файлового хаоса.
-
Перенёс в Обсидиан список 2308 видео на своём Ютуб-канале. Аргументы: это реестр отчуждённых активов; в случае блокировки/удаления канала Гуглом этот список остаётся единственной твёрдой копией структуры моего репутационного капитала; список является “слепком” моего нетворкинга, видео в котором подтверждают связи и ценны для экспертов более, чем для меня; это готовый массив экспертизы (хотя во многом устаревшей), который в будущем может быть проиндексирован ИИ и использован для линкования заметок в графе; это история моей эволюции, подобная истории публикаций в клубе МИМ.
-
Расчистил архив в Дропбокс основательно, всё, что не имеет оснований там находиться, оттуда перемещено либо на склад, либо в цех/транпортную шину, либо на “холодное хранение” на флешку.
-
Четыре списка - прочитанных книг, контактов спикеров, видео на ютуб-канале, пройденных курсов Усанова со ссылками на контент - теперь в одном месте в транспортной шинe в папке registry. Надо научиться с ними работать средствами Обсидиана.
-
О фиксации ошибки накопления WIP, осознанно мной допущенной:
- накопление сырых образовательных заметок в контексте ACQ (в моём случае от чтения литературы по прикладным дисциплинам методов, которые я использую для рефакторинга без их немедленной интеграции в граф знаний) является критической ошибкой управления потоком создания ценности. Нарушается принцип поставок мелкими партиями, накапливается wip в контексте ACQ в виде образовательных заметок, срок действия которых не более 7 дней (у меня же они лежат неделями, или я планировал, чтобы они накапливались - то есть планировал производство брака, сознательное “протухание”, которое потребовало бы заново перечитывать книгу, чтобы вспомнить, почему писалась эта заметка; очистил цех от заметок, всё перенёс на склад, который теперь захламлён, и нужно думать про его расчистку);
- создание избыточных запасов информации квалифицируется как чистая потеря. Увеличивается Lead Time: время от момента получения знания до момента его физического осознанного воплощения в инкременте экзокортекса стремительно растёт. Возникает когнитивная иллюзия продвижения по проекту - “проглочена книга”. Однако с точки зрения системной инженерии прогресс равен нулю, так как инкрементов в экзокортексе не появилось, заметок в графе знаний тоже. Знания из источников должны воплощаться либо в изменении своих методов (спецификаций контекстов), либо в заметках графа знаний, либо в инкрементах целевых систем;
- накопление заметок без их “прорастания” в инкременты экзокортекса и элементы графа знаний создают риск накопления структурных дефектов (если в старом допущена ошибка, она не обнаруживается тут же, а новое накладывается на ошибку; это минус обучения самостоятельно). Без закрепления каждого шага в виде инкремента у меня отсутствует стабильная точка отсчёта для дальнейшего рефакторинга. Накопление заметок без создания на их основе инкрементов экзокортекса остаётся накоплением заметок, причём протухающих, без изменения экзокортекса. Что с чтением, что без чтения - экзокортекс не изменяется. Поэтому читать с созданием заметок имеет смысл только ради производства инкрементов после заметок, иначе можно не читать вообще - это вчистую зря потраченное время сейчас, которое можно с толком потратить на реальное создание инкрементов. Чтение ради будущего изменения целевого объекта, но с откладыванием этого изменения в неопределённый срок - это когнитивная подмена действий по изменению иллюзией этих действий, постоянной подготовкой (вечное чтение без последующих действий по изменению как иллюзия изменения - “но я же читаю”);
- для предотвращения деградации данных, я ограничиваю вовремя отловленное накопление WIP - замораживаю чтение дальнейших книг после прочитанных Якобсона, Косякова и Ланхама, пока не обработаю составленные и протухшие по ним заметки. Заметки по каждой из трёх прочитанных этих книг подлежат переработке в такте А синтеза в граф знаний (узлы графа), после чего по прочитанному должен быть создан инкремент в экзокортексе (если они уже не создан ранее). Либо отмечается, что теперь понятно, почему LLM рекомендовала сделать такой-то инкремент, и я произвёл его, пусть и без понимания метода и его прикладной дисциплины, просто как ученик.
-
Год назад у меня не было Обсидиана (я даже о нём не знал), и был Notion со складом информации. Теперь у меня нет Notion (я удалил в нём аккаунт), а весь интеллектуальный капитал в Обсидиан, в котором я учусь работать по своим SoTA-методам и который является “линзой” для просмотра и изменения документов в транспортной шине, которые не зависят от Обсидиан как от инструмента. Даже если Протон и Обсидиан исчезнут, то я восстановлю свой граф знаний из бэкапа в другом облаке/текстовом редакторе. С Notion у меня была бы зависимость от серверов его поставщика, и риск потери графа (что означало бы неизбежную миграцию потом в Обсидиан при понимании этого риска).
-
Кто такой SoTA-деятель (деятель с SoTA-архитектурой) и SoTA-экзокортексом:
-
это система создания, максимально эффективно усваивающая энергию и информацию из внешней среды и использующая её для упорядочивания внешней среды, создания разных целевых систем с максимальной производительностью. Экзокортекс является его подсистемой, конструктивно представленной аппаратно-программной инфраструктурой, которая расширяет ограниченные когнитивные возможности биологического мозга человека;
-
это агент, который осознанно меняет состояние мира, создавая или изменяя целевые системы (включая себя и свои подсистемы), действуя для этого в определённых ролях, в которых применяет конкретные прикладные методы;
-
методы, применяемые деятелем, наиболее современные и эффективные на данный момент времени (SoTA). Он не “изобретает велосипеды” и не пользуется устаревшими методами и моделями, а всегда интересуется/ищет SoTA-методы в данной прикладной области, находит их, обучается и внедряет;
-
деятель чётко отделяет себя как личность от своих ролей, понимая, в какой роли действует в каждый конкретный момент, какие у неё ролевые интересы, метод и рабочие продукты. Вход и выход из роли происходят осознанно, без спонтанности и автоматизмов (ролевое мастерство);
-
поскольку окружающая среда постоянно меняется и знания меняются, всё устаревает и меняется SoTA, деятель постоянно отслеживает изменения методологического и технологического ландшафта (проактивно, а не реактивно инициируя изменения себя), оперативно обновляя/развивая свою архитектуру (набор методов). Деятель в любой момент знает конечный набор своих методов (архитектуру) и уверен, что они SoTA (а если обнаружится не так, инициируется обновление метода до SoTA);
-
SoTA-экзокортекс является активным инструментом мышления, а не пассивным архивом информации в папках на дисках. Это не склад мыслей и контента (хотя склад источников качественной информации для переработки является частью экзокортекса), а как внешнее вычислительное пространство, позволяющее эффективнее использовать возможности двух систем мозга. Экзокортекс оптимизирован под быстрое извлечение контекста и генерацию новых смыслов через семантические связи;
-
информация в экзокортексе хранится не в иерархических папках, а в виде сети (семантического графа) атомарных “вечнозелёных”/evergreen заметок. Это позволяет структуре знаний развиваться снизу вверх, адаптируясь под меняющиеся задачи деятеля, его прикладные методы и роли;
-
используется управление конфигурацией базы знаний с применением к ней строгих инженерных подходов: версионирование, фиксация baselines, разграничение уровней зрелости информации и автоматическая валидация связей;
-
сопряжение SoTA-методов и SoTA-экзокортекса, поддерживающего как инструмент/технология работу по этим методам, возникает эмерджентное свойство человеко-машинной (киборг) системы - минимизация когнитивного трения при переработке информации. В ней образуется творческий конвейер, частью которого является контур инфометаболизма ACQ-SYN-PROD. Потребляемая из внешнего мира информация превращается в целевые системы, созданные деятелем (изменение мира);
-
на стадии потребления информации (ACQ) происходит обработка отобранного входящего потока качественной информации, рабочим продуктом которой являются образовательные/исчезающие/fleeting заметки (шарды);
-
на стадии размышления/синтеза (SYN), состоящего из двух тактов А и Б, происходит переработка образовательных/исчезающих заметок в заметки графа знаний, визуализация связей между ними. Результатом является накопление структурированного знания, рост плотности графа, ядра интеллектуального актива;
-
на стадии производства (PROD) происходит отбор готовых блоков знаний из графа и их агрегация в черновики будущих публикаций, управление их версиями. Результатом является быстрая отгрузка/выгрузка готовых артефактов во внешний мир, их отчуждение, с ликвидацией стадии “чистого листа”, быстрая поставка инкрементов в надсистему.
SoTA-деятель с SoTA-экзокортексом - это система (конструктивно представленная биологическим агентом и аппаратно-программным комплексом), оптимизированная для максимальной производительности и эффективного изменения мира за счёт создания целевых систем и минимизации WIP. В ней агент-человек отвечает за выбор SoTA-методов и ролей, а экзокортекс - за технологическую/инструментальную поддержку этих методов через графовую архитектуру, автоматизацию рутины и жёсткие инженерные регламенты работы с данными. Это позволяет деятелю как системе создания выдавать инкременты в физический мир с максимальной скоростью и минимальными затратами биологического внимания.
-
Природа мыслительного резонанса при потреблении информации в контексте ACQ - в том, что мы читаем just in time, держа в голове запрос из SYN/PROD. И текст сканируется с поиском ответа на запрос. Если же читать just in case, просто так, из любопытства и без запроса, то надо либо переписывать весь текст в заметки (что абсурдно), либо не делать ни одной (что есть чистые непроизводительные затраты времени). Именно потому, что я читал just in case, у меня и возникал постоянно этот вопрос. Если же перерабатывать информацию под запрос, то он в принципе не возникает - ты точно знаешь, что ищешь. Маркер успеха выполненной работы по методу ACQ - пул образовательных заметок, строго соответствующих изначальному информационному дефициту, атрибутированных к источнику и готовых к транзиту в контекст SYN. Маркером деградации будет чтение ради чтения (результат - взрывное накопление WIP без целевого запроса), потеря ссылок на оригинал, параллельное потребление нескольких источников. Отсюда запрет на чтение как ритуал/привычка без чётко сформулированного запроса от контекста выхода (для блокировки генерации скрытого wip по привычке/автоматизму); глубокое осмысление и переписывание своими словами тоже не на данном этапе, тут только экстракция нужных знаний под запрос (потому что их нет в графе, вот и надо экстрагировать из источника); запрет на чтение более одного источника и на сохранение данных без точной ссылки (иначе будет разрушаться граф знаний). У меня, конечно, глубочайшим образом укоренённая привычка читать неправильно, из-за которой мне даже сложно врубиться, как работать по правильному методу информационного метаболизма.
-
Результатом такта А синтеза является переработка образовательных/исчезающих заметок (срок жизни не более 7 дней, потом можно выбрасывать) в evergreen атомарные zettel-заметки графа знаний, который вечен. После выполнения данного такта буфер образовательных/исчезающих заметок обнулён (их там нет), граф знаний дополнен новыми заметками, тегами и связями, он разросся, заметок и связей стало больше. Заметки пишутся исключительно своими словами, когнитивная нагрузка наивысшая (работает TPN-сеть), делегировать этот такт LLM нельзя (это означало бы разрушение механизма синтеза знаний у себя в голове). В такте Б из симпатичного графа под запрос о создании нужного будущего артефакта открывается “пустой холст”, на него извлекается кластер/набор нужных evergreen заметок (чему помогают связи между ними), происходит линеаризация (выстраивание сетевым образом связанных атомарных смыслов в последовательный нарратив, логически раскрывающий тему будущего артефакта от начала до конца, например по принципу 4P, от проблемы положения дел к направлению решения и конкретным действиям), написание связующего текста (“когнитивного клея”) между блоками. Ранее я проделывал этот процесс из головы (там был граф) на майндкарте. Маркером успеха метода является то, что масса рождающегося черновика не менее чем на 2/3 состоит из ранее созданных evergreen заметок, процесс его сборки/создания напоминает конструирование из готовых ранее созданных актуальных блоков текста, а не написание его с чистого листа (отсюда логично, что такой черновик будет создаваться гораздо быстрее, а производительность такого метода будет сильно выше). Маркерами же деградации будет попытка написания текста “из головы”, с чистого листа, без предварительного создания и связывания атомарных заметок в графе (игнорирование графа). У меня просто этот граф образовался в голове от усиленного чтения и обдумывания, просто он не был визуализирован, что есть хуже, но он как-то позволял отбирать из него кластер нейрозаметок в готовый продукт. Контекст синтеза является абсолютным математическим бутылочным горлышком/bottleneck агента. Запрет на избыточную обработку/бесконечную оптимизацию структуры графа/заметок/связей (рефакторинг ради рефакторинга, прокрастинация), если это не обслуживает текущую потребность такта Б.
-
Деление на два такта для того, что в первом задача - искать неочевидные сетевые связи между концептами, во втором - выстраивать жёсткую линейную логику от проблемы для решения между нужными концептами в контексте создания конкретного артефакта, у которого своя задача (он не есть граф, его задача - не включить всё знание, а отобрать дозу нужного под конкретную задачу, сделать вброс в другую аудиторию, он не работает на знания владельца графа, а работает на их отчуждение в мир). Смешение этих двух тактов невозможно, это же очевидно.
-
Для удержания себя в ролях в контекстах ACQ, SYN-A, SYN-B, PROD они должны быть жёстко аппаратно-программно разделены, с высокой когнитивной стоимостью входа в каждый, чтобы блокировать автоматические переключения между ролями и контекстами, которые легко провоцируются их нахождением в общем контуре инфометаболизма.
-
Моё ключевое непонимание - это непонимание между деятелем как производством/системой создания и обывателем как не-производством/потреблением/переработкой энергии и информации в отходы жизнедеятельности без изменения мира к лучшему. Если речь идёт о производстве, логика его предельно понятна, подчинена запросу на выходе и жёстким физическо-праксиологическим ограничениям, инженерии. Тут сразу встают вопросы целей, средств, эффективности, прибыли, методов, рисков и так далее, потому что происходит упорядочивание мира, имеющее цену, Если же речь идёт о простом обывательском существовании, переводе энергии и информации в рассеивание, увеличение энтропии себя и мира, то категории инженерии и эффективности тут просто неприменимы, тут нет деятельности, об эффективности которой кому-то интересно задуматься (её инициатору и главному бенефициару). Но простое обывательское существование тоже есть созидание чего-то, упорядочивание, только гораздо в меньших масштабах и могущее существовать в неэффективном виде столько, сколько оно поддерживается вливанием внешних ресурсов (особенно в фиатной госсистеме, но так же может происходить и в неэффективном бизнесе, проедающем капитал).
-
Я нахожусь в процессе глубокого рефакторинга своего когнитивного процессора:
-
это переход от модели “склада знаний” (потребления/образования впрок, just in case) к модели “производственного конвейера” (профессиональная деятельность экономиста АЭШ и криптоэнтузиаста, just in case);
-
почему нужно идти от конца к началу, а не наоборот? Почему нужно потреблять информацию под выдачу, а не просто потреблять впрок? Потому что потребление впрок является производством брака: качество синтеза непонятно какое; генерируется большой WIP; дефолтная сеть мозга завалена им и генерирует руминации. Иначе говоря, это перевод сырья и времени с крайне низким КПД, который забывается и возникает желание перечитать книгу, и приходится признать, что в этом режиме я жил 20 лет, хотя когнитивное давление от избытка потреблённых знаний таки вывело меня на дорожку их выдачи в онлайн-формате в разных ролях;
-
в инженерии целевая система определяет архитектуру системы создания, а не наоборот (набор методов и инструментов). Если неизвестна целевая система, то система создания непонятно какая и работает вхолостую, склад сырья переполняется, генерируя информационную энтропию и wip;
-
да, можно писать из головы на основании текущей нейронной сети, не читая новых книг. Но что если в текущей сети обнаруживается отсутствие знаний, “белое пятно” в некоторой области? Для его закрытия и нужно искать недостающие знания в новом источнике, потребляя его осознанно для ликвидации пробела. Логика: я ставлю задачу PROD - обнаруживаю “белое пятно” в графе знаний SYN - целевым образом иду в книгу за конкретным фрагментом ACQ. В результате книга читается не вся, а ровно в том объёме, который нужен для ликвидации дефицита знаний в текущем проекте (так же можно создавать прикладные знания в веб3, например; там мне в голову не придёт читать всё подряд). Это и есть SoTA-подход, это мне понятно.
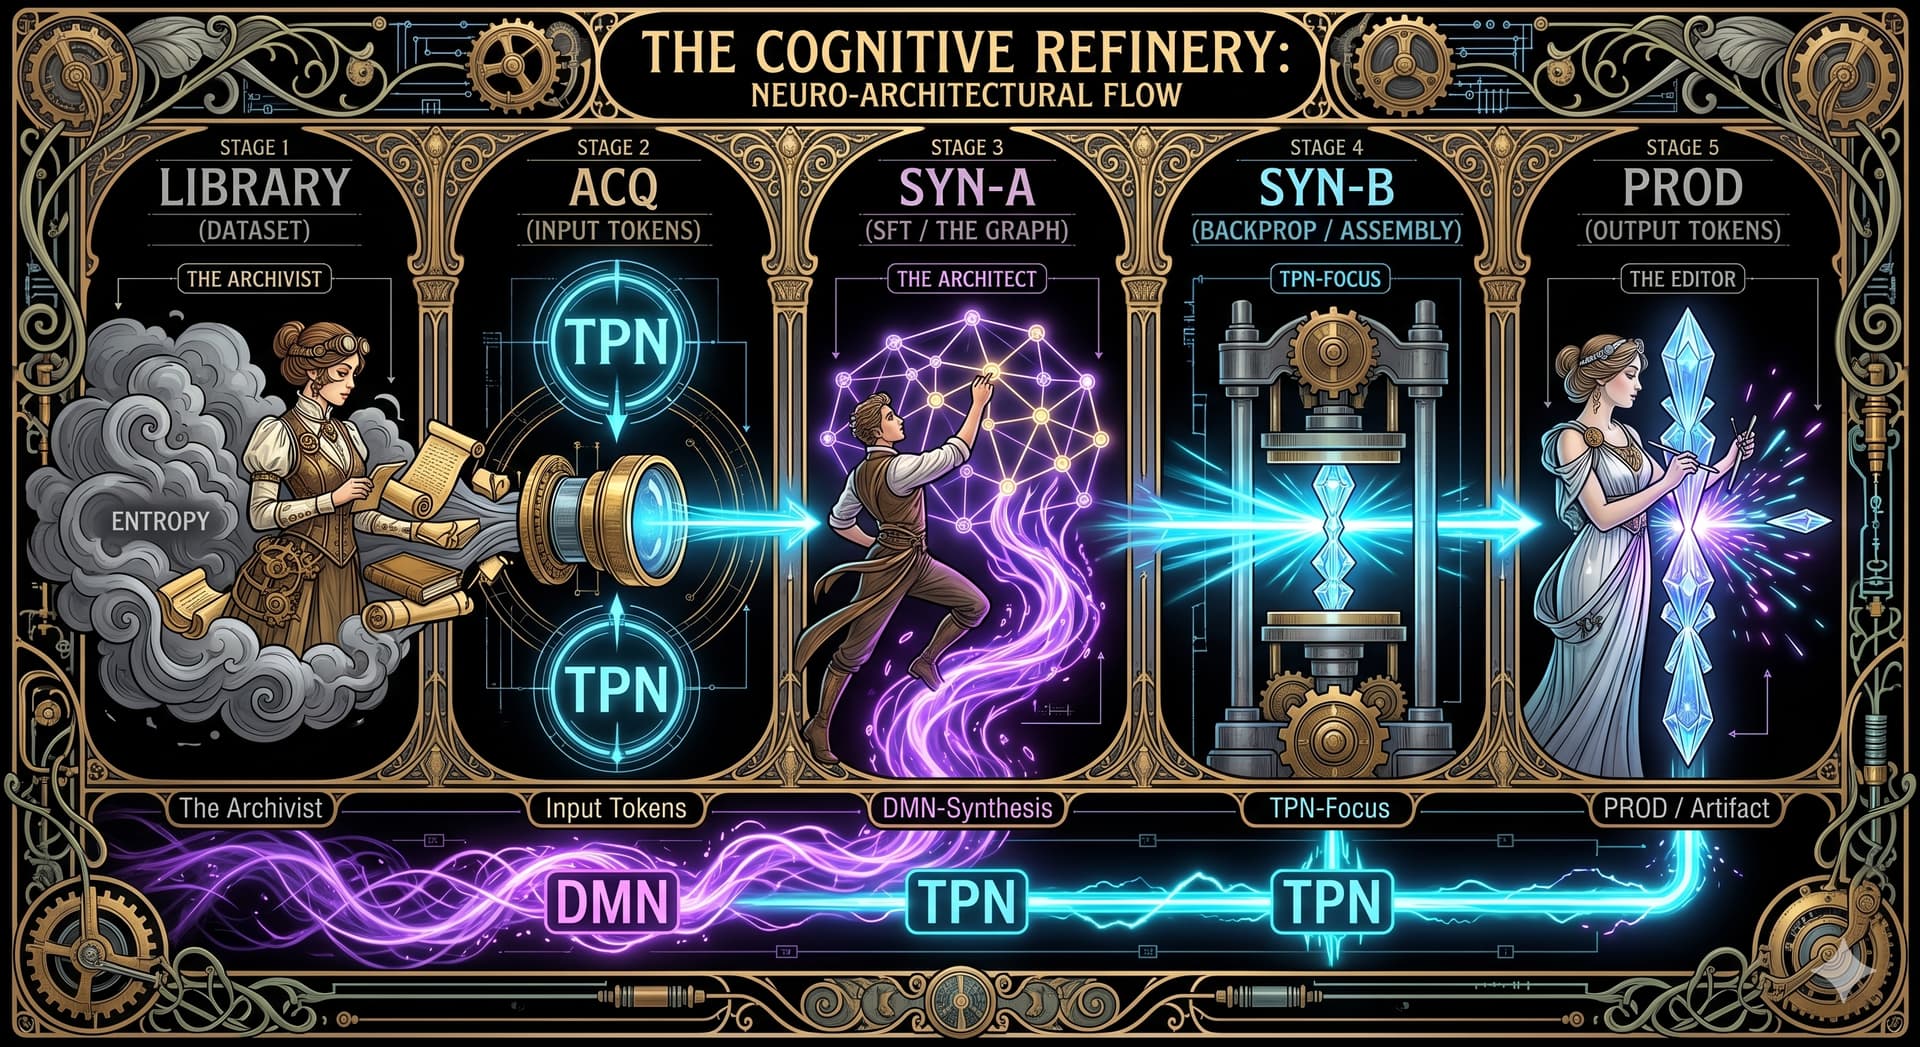
- Пять стадий информационного метаболизма:
- архив, роль “архивариус”, на входе - вся информация мира, процесс - отбор источников качественной информации по теме, на выходе - склад качественных текстов/лекций. Аналог LLM - датасет (pre-training);
- потребление ACQ, роль “исследователь”, на входе - отобранные источники, процесс - токенизация (парсинг текста, выделение резонирующих мыслей), на выходе - образовательные/мимолётные заметки (кванты мыслей, шарды). Аналог LLM - input tokens;
- синтез SYN, такт А, роль “архитектор смыслов”, на входе - образовательные заметки, процесс - атомизация (перевод чужих слов в свои концепты, связывание их в графе знаний), на выходе - атомарные/evergreen заметки и связи между ними. Аналог LLM - supervised fine-tuning;
- синтез SYN, такт Б, роль “сборщик”, на входе атомарные заметки (граф знаний), процесс - сборка черновика (выстраивание линейной структуры из нелинейного графа), на выходе - черновик (WIP). Аналог LLM - выравнивание весов (backprop);
- производство/выдача PROD, роль “выпускающий редактор”, на входе черновик, процесс - финализация (огранка/редактирование текста под формат канала и целевой аудитории), на выходе - готовый текстовый артефакт (заготовка/публикация), отчуждённый в мир (копия - в граф знаний read-only). Аналог LLM - output tokens.
- Как минимизируется wip в контуре инфометаболизма, чтобы не создавать когнитивных заторов и не “гнать брак”? Три правила:
- никакого чтения впустую/просто так/из любопытства/по привычке just in case. Если источник не помогает решить текущую задачу/создать инкремент/продвинуться в знании/изменить метод, он остаётся в архиве (как и миллионы других до него). Это не запрет на знания - это банальная защита от энтропии. Если бы кухня кафе начинала перерабатывать продукты из холодильника просто по факту их положения туда, а не по факту приёма заказа от клиента, то она просто их перевела бы, и кафе быстро разорилось. Более того, из всех продуктов мира в данном кафе появляются благодаря снабженцу только те, которые имеют ценность для создания продаваемых клиенту блюд, и ничего другого там не появляется, так как это означало бы растрату ресурсов денег и площадей для хранения;
- образовательные/исчезающие заметки должны превращаться в zettel/evergreen/атомарные в графе в течение их срока годности - 7 дней. После истечения этого срока становится сложно вспомнить, почему эта заметка вообще была создана, по какому поводу был “мыслительный резонанс”, она “протухает” и может быть безжалостно выброшена, никакой потери, кроме затраченного времени на чтение для её генерации, тут нет;
- заземление через публикацию. Пока черновик не опубликован, синтез считается незавершённым. Публикация - это финальная фиксация весов внимания в моём мозгу. После нёе работа по синтезу выполнена, готовый артефакт отчуждён в мир и начал его менять, леса (черновики и исходники) для его производства могут быть демонтированы.
-
Деятель - как завод. Цель создания завода - создание и отгрузка готовой продукции клиенту за деньги. Цель деятеля - изменение мира (создание инкрементов). Для создания готовой продукции завод закупает сырьё, которое поступает на склад, и перерабатывает его в готовую продукцию. Если завод только закупает сырьё, пожирает его, захламляя цех, но ничего не создаёт и не отгружает клиентам, он не работает по назначению и никому не нужен, никто не будет тратить на его содержание ресурсы, и он скоро превратится в свалку и заглохнет. Если деятель будет только потреблять информацию, но не будет производить в физическом мире инкременты, он не деятель, просто тратит время и энергию, потребляемую из внешнего мира, в качестве хобби, и превращается в свалку протухающих знаний, не получающих выхода, потребляемых ритуально. Задача деятеля - делать так, чтобы каждая единица сырья на входе, закупаемая для производства инкрементов, как можно быстрее превращалась в инкременты, изменяющие состояние физического мира, или публикации/контент (которые тоже изменяют состояние мира, воздействуя на других). Но управляет поступлением сырья на склад и его переработкой именно цель на выходе. В противном случае, если цели нет, рассуждая логически, нужно либо потреблять всю информацию, созданную человечеством, либо отказаться от потребления/инфометаболизма вообще - результат будет одинаков, изменения мира нет, деятель превращается в бесполезную свалку или умирает. Выбор - либо потреблять информацию под будущее конкретное изменение, либо не потреблять вообще.
-
Как две сети мозга работают на обоих тактах синтеза, в ходе которого происходит реальное изменение моих нейронных связей (обновление “весов внимания”):
- в такте А я беру образовательную заметку, записанную словами автора, и пересобираю её своими словами. Зачем? Это акт синтеза смысла (мышления письмом, в ходе которого образуются нейронные связи в моей нейросети) - пока я не написал мысль своими словами/не перефразировал, и не поставил ссылку на другую заметку в графе, нейронная связь не сформирована. Перефразировал/переписал своими словами - считай, физически сформировал/прописал в мозгу новую нейронную связь. Результат: моя DMN-сеть освобождается от удержания этой мысли, так как она отчуждена и зафиксирована надёжно в структуре графа. Если не разгрузить её, то мимолётные/исчезающие/образовательные заметки будут “вариться” в DMN-сети, тухнуть, забываться, сеть будет генерировать руминации и беспокойство. Переписывание же заметки - это мощное включение природной функции DMN, асинхронного генератора ассоциаций. В такте А она используется для сканирования графа для поиска нетривиальных связей. Если связь обнаружена, всё, что нужно - это сохранить её, проставив ссылку на иную заметку, зафиксировать во внешнем энергонезависимом графе, освободив DMN от задачи её удержания/разгрузить. В результате происходит физическая ликвидация wip и предотвращается превращение DMN в генератор тревоги. Аналогом переработки мимолётной заметки будет переработка входящей заготовки на станке в полуфабрикат, освобождение ящика для заготовок, продвижение заготовки по циклу производства к стадии готовой продукции. Накопление же мимолётных заметок означало бы накопление заготовок без их обточки токарём;
- в такте Б происходит архитектурная сборка будущего готового текстового артефакта. Текст не пишется с нуля, да и не может - просто клонируются нужные связанные заметки из графа в пустой холст будущего черновика, которые далее остаётся склеить логическими переходами. Работает TPN-сеть, которая линейная, мощная, но катастрофически малоёмкая. Поэтому сборка черновика из блоков-заметок менее энергозатратна и более быстра, чем писать черновик из головы с чистого листа, мозгу не нужно одновременно копаться в памяти и вспоминать нужные факты/куски/данные/концепты/тезисы (они уже в заметках перед глазами), ему нужно только увидеть нужные, отобрать их, перетащить на холст/в черновик и выстроить в линию (превратить сетевую связь в линейно-логическую - для других, не для себя, для себя уже есть граф, который круче по содержанию, но его же нельзя отчуждать в мир целиком). Результат - появление черновика, который на 2/3 минимум состоит из готового ранее созданного интеллектуального капитала, причём он мог быть создан годы и десятки лет назад, и по-прежнему релевантен. Работа TPN значительно облегчается за счёт использования уже готовых связей, а не генерации их с “чистого листа”. Написание текста с нуля заставляет TPN одновременно: удерживать смысл готового продукта; искать факты/данные; строить синтаксис. В такте Б она просто переводится в режим линейной сборки из модулей, которые ранее подготовлены и связаны в такте А;
- почему эти такты разделены, не могут быть слиты в один этап синтеза? Потому что это разные контексты (логика действия - метод, роль, двигаемая альфа, рабочий продукт; пространство; время). Попытка смешать контексты в одном - одновременно и искать сетевые связи (нелинейная DMN) и строить последовательный черновик (линейная TPN) вызывает когнитивную интерференцию (разные процессы, разные системы мозга - задействовать одновременно; в FPF контексты нельзя смешивать). Важная роль слота рекреации между тактами: в нём DMN может доварить ассоциации в фоновом режиме, пока TPN заслуженно отдыхает;
- разделение ответственности. В такте А не висит задача отгрузки готового текста в дедлайн - можно спокойно отдаться поиску ассоциаций и любовному построению графа; в такте Б задача не создавать связи, а сконцентрироваться/сфокусироваться на отборе готовых блоков и связей в будущий текст - даже если им будет недовольство, связи и блоки же никуда не денутся, можно это будет просто учесть и в следующий раз отобрать более качественно. На качество же графа и знаний в нём их отбор для конкретного текста в такте Б не влияет, это клонирование, копирование в усечённом виде.
-
Обсидиан - это визуализатор топологии моего мышления. Без него zettelkasten был бы “чёрным ящиком”. С ним - я вижу веса внимания между концептами. Чем больше линков между заметками я синтезировал в такте А, тем проще по этим рельсам ехать при сборке черновика и тем меньше энергии потребуется TPN для прокладывания по ним маршрута. Фактически, граф знаний и Обсидиан позволяет произвести правильную аллокацию вычислительных мощностей биологического субстрата, “разделение труда” между двумя системами мозга, задействование каждой из них для тех задач, для которых она лучше приспособлена. В результате разбиения синтеза на два такта производительность на каждом из них вырастает, что сказывается на интегральной производительности. В высшей степени нерационально использовать критически малую емкость памяти TPN для удержания огромного объёма фактов/данных контекста - она просто не сможет это сделать, поэтому весь контекст реального проекта выносится в экзокортекс. Так же нерационально использовать нелинейную рыхлую ассоциативную DMN для попытки линейной сборки текста, требующей напряжения - она просто не справится с этой задачей, легко посильной TPN.
-
Разделение труда и ответственности между двумя системами мозга на этапе синтеза следующее:
- линейный фокус TPN отвечает за роль логика и корректора. Они проверяют соответствие готового артефакта критериям площадки, устранение логических нестыковок, контроль синтаксиса;
- асинхронная ассоциативная DMN отвечает за роль цензора смыслов. Он проверяет целостность текста на предмет раскрытия темы/переданного смысла, чтобы он звучал и воспринимался как единый месседж, а не как набор относящихся к делу, но разрозненных фактов, отобранных нерадивым автором из глубин своих знаний, чтобы отвязаться от читателя;
- TPN выполняет работу по редактуре, с привлечением ИИ-сопроцессора, снимающего нагрузку. DMN включается на этапе финальной вычитки, и если возникает зуд/ощущение фальши - это сигнал о том, что структура синтезирована не полностью.
- Роль LLM как сопроцессора в контуре информационного метаболизма:
- аутсорсинг рутины и затрат энергии на неё, освобождая мозг для чистого синтеза смыслов;
- используется не только разделение труда между системами мозга, но и сопроцессор, усиливающий одну из них - выжимание максимальной производительности;
- на этапе потребления информации ИИ может сделать суммаризацию текста источника, чтобы понять, стоит ли тратить на него время, есть ли в нём то, что меня интересует, и где именно;
- в такте А синтеза ИИ может выступить спарринг-партнёром для поиска неочевидных связей смыслов в синтезированной моим мозгом заметке с другими, принудительно расширяя поиск DMN (усиливая последнюю);
- в такте Б синтеза достаточно скормить ИИ отобранный кластер заметок и попросить собрать из них черновик будущего артефакта, не добавляя ничего от себя, что снижает до нуля затраты когнитивного ресурса на синтаксическую сборку;
- на этапе отгрузки готового артефакта ИИ выступает редактором, калибруя стиль и ритм/формат под нужную целевую аудиторию.
- Отсутствие контура информационного метаболизма означало бы физическую смерть мозга:
- у любого биологического агента есть контур инфометаболизма, в котором происходит извлечение информации из внешней среды, синтез/связывание её в концепты, формирование таким образом картины мира и использование её для выдачи ответа/реакции на любой внешний запрос. Картина мира меняется в результате обучения, которое может быть осознанным или нет. Любая открытая система, чтобы противостоять энтропии, обязана поглощать сигналы из среды, обновлять свою внутреннюю модель/картину мира, и выдавать реакции (ответы/продукт);
- фундаментальное различие между агентом по умолчанию (неосознанным обывателем, как-то потребляющим информацию из среды и как-то синтезирующим в голове картину мира) и агентом со спроектированным экзокортексом заключается не в наличии контура, а в уровне его энтропии и метриках управления (иначе говоря, в методах работы с информацией - потребления, мышления, выдачи);
- в фазе поглощения информации агент по умолчанию будет поглощать её хаотично, управление перехвачено дофаминовыми триггерамия (эволюционной реакцией на новизну), контекст поглощения забивается высокоэнтропийным фаст-фудом (соцсети, новости, слухи), фильтры на входе отсутствуют, это положение дел им даже не осознаётся. В спроектированном экзокортексе поглощение информации агентом детерминировано спецификациями макро-контекста ACQ, входной поток ограничен лимитами wip диспетчера, среда сканируется только на предмет sota-знаний, релевантных утверждённой стратегии;
- в фазе синтеза у агента по умолчанию он осуществляется в фоновом режиме DMN. Поскольку сырьё хаотично, система генерирует не отчуждаемые заметки, а руминации (навязчивые мысли), тревогу или бытовые выводы. Граф знаний такого агента не формализован, доступ к нему зависит от биохимического состояния субстрата (настроения, усталости). В спроектированной же системе синтез выведен из головы на внешние носители (мышление письмом в экзокортексе). Двухтактный узел SYN принудительно переводит сырьё в дискретные evergreen концепты. Накопление капитала происходит независимо от настроения;
- в фазе отчуждения продукта у агента по умолчанию продуктом является рефлекторная реакция на среду - бытовой диалог, импульсивное действие или выполнение рутинной инструкции на рабочем месте без понимания архитектуры процесса. WIP постоянно теряется из-за перебиваний. В спроектированной же системе выдача формализована в контексте производства. Существует критерий definition of done. Продукт упаковывается и отчуждается с целью увеличения социального или финансового капитала агента;
- контур информационного метаболизма архитектурно предшествует занятию любых прикладных ролей в рабочих проектах. Даже если их нет, он есть. Когда агент со спроектированным экзокортексом входит в рабочий проект в прикладной роли, он просто подключает функционирующий и налаженный контур информационного метаболизма к АPI внешней системы. Она даёт специфическое сырьё (ACQ), экзокортекс и двухтактный метод обрабатывают его быстрее и с меньшим процентом брака, чем у обычных агентов (SYN), я выдаю продукт, который обменивается на ликвидность (PROD). Таким образом, инженерное выстраивание этого контура гарантирует, что при интеграции в любую новую надсистему я буду функционировать с предсказуемой пропускной способностью, защищая свой биологический субстрат от перегрузки благодаря маршрутизатору и лимитам wip. Вход же в роль агента-обывателя ставит его в состояние стресса и увеличивает объём хаоса в его голове, руминаций и тревог.
- Архитектура LLM оперирует строгими математическими абстракциями - токенами и весами внимания. Понимание их физики позволяет откалибровать модель информационного метаболизма агента, так как они являются прямыми эквивалентами моих узлов поглощения ACQ и синтеза SYN:
- токены как кванты информационного сырья. Это атомарные/неделимые единицы данных, которые вычислитель ИИ способен принять на входе и сгенерировать на выходе. Человеческое восприятие оперирует знаками/словами, указывающими на объекты/концепты. Кремниевая нейросеть слов не понимает. Поэтому перед попаданием в контур обработки ИИ текст проходит через препроцессор/токенизатор. Он дробит текст на фрагменты: слова, слоги и отдельные символы. Каждому токену присваивается уникальный ID, который затем разворачивается в многомерный вектор. Этот вектор содержит базовые математические координаты токена в многомерном семантическом пространстве;
- в моей архитектуре информационного метаболизма токен - абсолютный эквивалент сырья на этапе поглощения ACQ. Вытягивая информацию из внешней среды, я дроблю массивную книгу на атомарные факты и цитаты. Токен - это минимальный объём wip, который система может взять в обработку на одном такте;
- если токены - это изолированные детали на складе, то механизм внимания - это сборочный цех, который определяет, как эти веса внимания связаны между собой. Это ядро архитектуры Трансформера, заменяющее линейное чтение матричными вычислениями. В естественном языке значение токена зависит от контекста. Когда LLM обрабатывает последовательность токенов, для каждого токена вычисляется математическая оценка (вес) его связи со всеми остальными токенами в текущем контекстном окне. Вектор каждого токена разделяется на три сущности: query (что токен ищет в контексте), key (что токен сообщает о себе другим) и value (смысловая нагрузка токена). Вес внимания вычисляется как скалярное произведение query одного токена на key другого. Чем выше получившийся коэффициент (вес), тем сильнее нейросеть будет опираться на этот связанный токен при интерпретации текущего и при предсказании следующего. Веса внимания - это математический эквивалент моего контекста SYN и графа Обсидиан. Когда я создаю заметку и связываю её ссылкой с другой заметкой, я вручную задаю вес внимания между двумя концептами. В процессе обучения (supervised fine-tuning) LLM корректирует миллионы таких весов, чтобы зафиксировать правильные логические связи математически. Чем качественнее обучение, тем точнее веса отражают фундаментальные законы (выраженные семантически). На этапе обучения LLM скармливают терабайты токенов. Она пытается предсказать следующий. Если предсказание ошибочно, то на этапе SFT запускается алгоритм обратного распространения ошибки (backpropagation), который пересчитывает и корректирует матрицу весов внимания по всем слоям нейросети (веса меняются). Это процесс формирования стабильных связей с максимальными затратами когнитивного ресурса (синтез);
- на этапе выдачи (когда обучение остановлено, матрица весов заморожена - они зафиксированы), при поступлении внешнего запроса (промпт) модель переводит его в токены, прогоняет их через зафиксированную матрицу весов внимания и, опираясь на эти вероятности, генерирует/предсказывает наиболее статистически обоснованный следующий токен. Точность LLM (её способность не генерировать галлюцинации и отвечать строго по спецификации) зависит исключительно от того, насколько корректно были откалиброваны её веса внимания на этапе обучения/синтеза. Бесконечное же увеличение количества токенов на входе без качественной настройки весов/калибровки ведёт лишь к деградации полезного сигнала. То есть поглощение информации для целей обучения обязано сопровождаться экстракцией из неё смыслов и обновлением собственного графа знаний/весов внимания - если это не планируется делать/не делается в расчёте на то, что “как-то сами знания образуются в голове от количества/качества прочитанного”, то трата времени на поглощение информации без шардирования/атомизации/наращивания графа знаний является чистыми потерями. Потреблять информацию нужно либо правильно, либо не потреблять вообще (что невозможно, так как инфометаболизм работает, поэтому если она не потребляется правильно, она будет потребляться неправильно; у деятеля нет выхода, иного, нежели чем внедрить SoTA-методы потребления и мышления). В каком-то смысле деятелю нужно стать LLM.
- Биологический мозг (мокрая нейросеть) и кремниевая/сухая нейросеть работают по одним и тем же принципам:
- этап поглощения информации/ACQ - парсинг сенсорных данных/input tokens. Этап синтеза/SYN - прохождение сигнала через веса нейронной сети, сопоставление новых данных с накопленным опытом (графом), корректировка весов. Этап PROD (output tokens) - генерация моторного или вербального ответа;
- математическая идентичность архитектур биологического и кремниевого информационного метаболизма открывает возможность для создания гибридных вычислительных систем. LLM рассматривается в этом ключе не как заменитель агента, а как аппартный ускоритель, который снижает расход рабочего ресурса агента на рутинные операции перевода форматов и поиска по базе, высвобождая мощность субстрата агента для чистой генерации смыслов. Мозг агента - центральный процессор, LLM - сопроцессор, забирающий рутину, на которую нецелесообразно тратить ресурс мозга агента. Главным риском тут остаётся атрофия биологической нейросети агента от попытки делегировать синтез LLM;
- на фазе поглощения/предобучения у агента низкая скорость парсинга текста и высокая когнитивная стоимость обработки водянистого контента. Роль ИИ - семантический фильтр и препроцессор. Сырой документ загружается в него, агент запрашивает экстракцию структурного скелета и списка нетривиальностей. LLM выполняет функцию радара, указывая на важные места. Агент направляет внимание TPN на зоны с максимальной плотностью полезного сигнала. Таким образом, контент на входе искусственно может быть сжат без потери для качества сырья;
- на фазе синтеза, которая представляет собой фундаментальное бутылочное горлышко, интеграция ИИ требует ювелирной точности, так как делегирование самого акта синтеза машине приведёт к остановке обновления весов в мозге агента;
- в такте А (атомизация сырья) у агента может наблюдаться “замыливание” взгляда при попытке перевести чужую мысль в свой концепт. ИИ играет роль спарринг-партнёра. Ему можно скормить свои и чужие мысли и попросить выступить в определённой роли, предусматривающей нетривиальную реакцию и оригинальные мысли в ответ. Таким образом, она не пишет мысль за агента, а принудительно расширяет пространство поиска для его DMN;
- в такте Б (архитектурная сборка черновика) главное ограничение агента - пиковая нагрузка на TPN при попытке выстроить линейную структуру из десятка заметок. ИИ выступает в роли синтаксического компилятора. Агент скармливает ему все релевантные отобранные им заметки со своими мыслями и даёт команду на сборку из них черновика текста, без добавления отсебятины. В результате получается грязный, но структурно связанный макро-черновик. Затраты когнитивного ресурса на сборку текста агентом падают почти до нуля;
- на стадии производства/отчуждения текстового артефакта для широкой аудитории ограничением агента является выполнение им роли редактора - вычитка, стилистика, редактирование и полировка текста, что вызывает рост WIP. ИИ тут выступает выпускающим редактором, трансформируя готовую семантику черновика в целевой синтаксис, воспринимаемый надсистемой. Агент скармливает ему черновик и задаёт формат/стиль. Результат - ИИ производит выравнивание/редактуру текста по заданным параметрам, устраняет тавтологию, калибрует ритм. Узел производства превращается из многочасового процесса редактуры в быструю сессию формата “просмотр изменений - утверждение - релиз”;
- на стадии аудиовизуального производства ИИ поможет сделать текст из труднопроизносимого речевым аппаратом в реальном времени в более легкочитаемый “говорящей головой” на камеру. Это роль фонетического адаптера, конвертация академического синтаксиса в разговорный ритм без потери плотности смыслов. В результате получается финализированный текст, легко читаемый на камеру, снижается брак записи и число дублей;
- главный риск при информационном метаболизме агента с LLM - попытка когнитивного аутсорсинга на этапе синтеза. Если агент будет избегать синтеза сам и просить ИИ написать по сырью готовый текст, он собственными руками уничтожит свой контур информационного метаболизма. Машина-то обновит свои веса и продукт выдаст, а вот и биологический граф знаний агента останется пустым. Агент деградирует из производителя смыслов в оператора ИИ;
- поэтому LLM имеет право работать только с двумя сущностями: сырьём на входе для его уплотнения и фильтрации перед чтением/потреблением агентом, и собственными атомарными мыслями агента из графа для их сборки и форматирования перед отчуждением.
- Про логи чатов ИИ:
- ответ LLM на мой запрос - это не заметка. Это протокол когнитивной сессии (тип источника качественной информации на входе). Ближайший аналог - транскрибация сессии мышления проговариванием с единомышленником. Ведь фактически беседуют два инженера, в головах которых системное мышление и fpf. Этот протокол точно ликвидирует “белое пятно”, которое и породило мой вопрос ИИ. Копипаст ответа в Обсидиан не делает его частью моей нейронной сети, и поэтому запрещён. Он должен пройти фазу активной реконструкции, выжимки главного, а остальное безжалостно отброшено. Ценности в данном тексте нет такой, чтобы его сохранять - его можно дёшево получить столько раз, сколько нужно, задав вопросы LLM, пока не наступит понимание у меня (то есть не будет сформирована нейронная связь мышлением письмом);
- ответ прочитывается, в нём выделяются атомарные принципы - те два-три тезиса, которые меняют мою модель поведения. 80% текста отбрасывается. Выделенные атомарные принципы переписываются своими словами (это я делал в заготовках с мыслями за неделю), используя специфику своего текущего проекта. Именно в момент перефразирования мозг выполняет работу по синтезу, создавая тем самым нейронные связи (мышление письмом);
- интегрировать извлечённый принцип в существующий узел моего графа знаний. Для этого в Обсидиан находится заметка, уже существующая, в которую добавляется новый пункт. Если ответ касается методов работы, то обновляются спецификации. Если ответ объясняет концепт, пополняется база знаний/моделей. Если ответ - это план действий по конкретной задаче, то создаётся инкремент;
- отчуждаемыми рабочими продуктами, таким образом, могут быть только три: обновлённая спецификация контекста; новая/обновлённая заметка в графе знаний; конкретный артефакт в реальном мире (инкремент, рабочий продукт, продвигающий альфу);
- таким образом, ответы ИИ нужно рассматривать как когнитивные строительные леса, которые нужны для строительства моей собственной стены знаний. Когда с их помощью стена знаний построена/достроена, леса должны быть демонтированы и удалены (в их сохранении более нет смысла, тем более что их можно в любой момент возвести снова);
- резюме: копипаст ответов запрещён; из них извлекаются атомарные принципы и излагаются своим языком; результатом является либо изменение метода, либо заметка в графе знаний, либо инкремент в физическом мире.
- О публикациях на внешних ресурсах/отчуждённых готовых артефактах:
- любая публикация на внешнем ресурсе - это отчуждённый интерфейс. Без возвращения копии в Обсидиан мой граф знаний становится “дырявым”: связи ведут в пустоту (линк надо поставить, но не на что - документа в Обсидиан нет, а ссылке на сторонний ресурс со временем может оказаться неработающей);
- если я сделал копию публикации в Обсидиан, я больше не боюсь того, что публикация на стороннем ресурсе исчезнет. Я всегда ссылаюсь на её надёжную копию в Обсидиан и знаю о её существовании, в любой момент могу её достать и предъявить и себе, и другому;
- если не оставлять копию, я могу просто забыть о том, что я когда-то об этом публично писал. О скольких своих публикациях я уже не помню, и не сосчитать. Но они мне не так уж важны как тексты, потому что играли больше роль для других, и другие о них помнят. А я помню, что эти знания я отчуждал на основании того, что они были и есть (если не забыты) в моих нейронных связях;
- я могу ссылаться из новых черновиков на свои старые публикации, что превращает разрозненные статьи в единое тело знаний. При поиске по ключевым словам я могу видеть не только то, что думаю сейчас, но и то, что уже официально заявил ранее. Поэтому любая моя активность в сети, которая потребовала синтеза, должна быть заземлена обратно в транспортную шину;
- если у меня есть тексты публикаций, их нужно перенести в формате маркдаун в папку PROD c префиксом о публикации. Файл именуется в формате
ГГММДД Название_статьи. Это позволяет мгновенно идентифицировать «застывшие» тексты в результатах поиска. В начале файла обязательно создаётся yaml frontmatter. Статус Read-Only в Obsidian реализуется через волевое решение не редактировать такой текст. Если требуется развить мысль, создается новая заметка со ссылкой на этот артефакт.
- “Кремниевое зеркало: калибровка собственного инфометаболизма через архитектуру LLM”:
- токены и веса внимания - математические эквиваленты узлов поглощения ACQ и синтеза SYN. Токен - квант информационного сырья. Веса внимания - ручное связывание заметок в Обсидиан (задание веса между концептами, определяемого числом связей заметки с другими);
- ИИ как со-процессор, а не заменитель мозга. На этапе поглощения - семантический фильтр, сжатие. На этапе синтеза - помогает расширить пространство поиска связей/ассоциаций DMN, быстро собрать черновик из кластера, облегчая работу TPN. На этапе производства выполняет работу редактора для нужной аудитории;
- монополия на синтез остаётся у биологического агента, запрет на делегирование синтеза ИИ. Попытка такого делегирования равнозначна собственными руками разрушению своего контура инфометаболизма, когнитивной атрофии и остановке обновления весов внимания в биологической нейросети агента, превращая его в оператора ИИ;
- любая внешняя отчуждённая активность должна быть возвращена в экзокортекс в виде текстов read-only публикаций с yaml. Это предотвращает появление “дыр” в графе и делает мой опыт отчуждаемым и вечным.
-
Ответственный человек обязан считать свои ресурсы, и это не только деньги - это время сначала. Уделяя его на кого-то, ты не вкладываешь его в то, что тебе нужнее, да ещё и разбодяживаешь (Павлють).
-
Целевая система - это что-то “в состоянии”. И надо понимать, каким действием оно пришло в это состояние. Всё, что делается в системном мышлении - это выявляются методы, которые переводят интересующие нас объекты мира в нужные состояния. Конечная цель деятеля как социотехнической системы - энергетический узел, которым он владеет, в котором будет обмениваться энергия, информация и материя. Дистиллят системного мышления (Павлють) - чистый навык инженера. Военное дело, инженерное дело - это оно и есть, ему обучают.
-
Книга Аренса описывает метод Zettelkasten с точки зрения когнитивной психологии и академической продуктивности. Для инженера-менеджера это технологический регламент для оптимизации контура инфометаболизма. Аренс вводит понятия, чётко разграничивающие типы артефактов, которые создаются в контуре инфометаболизма, и его разграничение позволяет устранить “бутылочные горлышки”:
- на этапе поглощения информации он жёстко разделяет fleeting notes (мимолётные/образовательные/исчезающие) - мусорные контейнеры для быстрых мыслей, и literature notes (структурированные выписки из источников, сделанные строго своими словами и привязанные к источнику). Первые - сырьё, второе - полуфабрикат, они не смешиваются. Вторые - не вечнозелёные заметки графа знаний, не засоряют его;
- на этапе синтеза появляются permanent notes - постоянные/evergreen/вечнозелёные заметки, составляющие суть графа знаний. Аренс объясняет, как перерабатывать информацию из этапа поглощения так, чтобы заметка становилась permanent, атомарной, автономной и содержала только одну законченную мысль, готовую к интеграции в общую семантическую сеть;
- на этапе производства/отчуждения готового текстового артефакта, в силу наличия двух предыдущих этапов, происходит не создание смыслов “с нуля”/“с чистого листа”, а естественная сборка (агрегация) уже существующих в картотеке/графе знаний постоянных заметок. Если этап синтеза работает штатно, то генерация готовых текстовых артефактов или еженедельных инкрементов превращается в линейный монтаж из готовых блоков.
- Мне нужно прочитать Аренса для решения следующих прикладных задач:
- управление wip. Метод Аренса позволяет “заморозить” состояние мыслительного процесса в виде текстового артефакта и вернуться к нему через месяцы без потери контекста. Логично, ведь если читать без заметок, или просто делать исчезающие, то через месяц уже и не вспомнишь, о чём читал и почему делал заметки, время на чтение с заметками будет потрачено зря;
- научное обоснование метода мышления письмом, который я практикую. Аренс подводит под него научную базу: биологическая рабочая память жёстко ограничена (TPN), и экзокортекс должен использоваться не как склад/архив, а как внешнее вычислительное пространство для расширения когнитивных способностей;
- переход от иерархического хранения к сетевому. Аренс наглядно доказывает ущербность традиционной каталогизации по папкам с вложенностью/иерархией (top-down), и обосновывает преимущества восходящего/сетевого/bottom-up проектирования, что критически важно для использования графа знаний в Обсидиан эффективно.
- При чтении нужно обратить особое внимание на следующие аспекты, сопоставляя их со своей текущей практикой:
- контекстные связи вместо категориальных. Важно не то, откуда пришла информация (рубрика, тема, папка), а то, в каком контексте она будет использована при производстве. Нужно сфокусироваться на создании связей между заметками. Ссылка должна отвечать на вопрос: “для какой задачи или проблемы эта мысль является решением?”, а не просто указать на смежную тему;
- индексы и карты контента. У Аренса это карточки-указатели, которые есть в моей архитектуре как карты контента. Они не должны быть перегружены, не быть жёсткими каталогами, а гибкими точками входа в семантические кластеры графа;
- стандартизация жизненного цикла заметки. Логика трансформации знания: как мимолётная мысль от резонанса фиксируется, превращается в тезис со ссылкой на источник, а затем интегрируется в тело основного графа. Для инженера это описание пайплайна данных;
- критическая масса системы. Аренс детально описывает феномен, когда система начинает “разговаривать” со своим владельцем - выдавать неожиданные пересечения смыслов и новые идеи за счёт плотности связей. Отсюда метрика - соотношение количества заметок к числу связей в моей текущей версии экзокортекса, чтобы оценить, насколько он близок к критической массе (на данный момент оно зашкаливающее, так как заметок много, а связей мало).
- За пять месяцев текущего года, 22 недели, я проделал путь от непонимания своей архитектуры как набора методов и попытки работать на ней, генеря wip и брак, до осознания, какой она должна быть, и её описания, понимания масштабов рефакторинга текущей архитектуры с жутким долгом до нормальной, то есть направления оргразвития, и начала её рефакторинга, упёршегося в невозможность работать дальше неправильно для производства нужных изменений, чтобы было правильно, и начинать надо с изменения контура своего метаболизма, в котором накоплен огромный технический долг. С 1 января к 1 июня я таки выхожу на Аренса.