- Завершил трёхнедельный спринт по освоению метода Лумана чтением книги Аренса по методам в контекстах ACQ, SYN под руководством LLM+FPF. Получен граф из 58 атомарных постоянных заметок (нод), из которых 20 уровня L4, 38 уровня L3. По ходу работы понял, что ИИ модифицировал исходный метод Лумана очень сильно, сделав его SoTA.
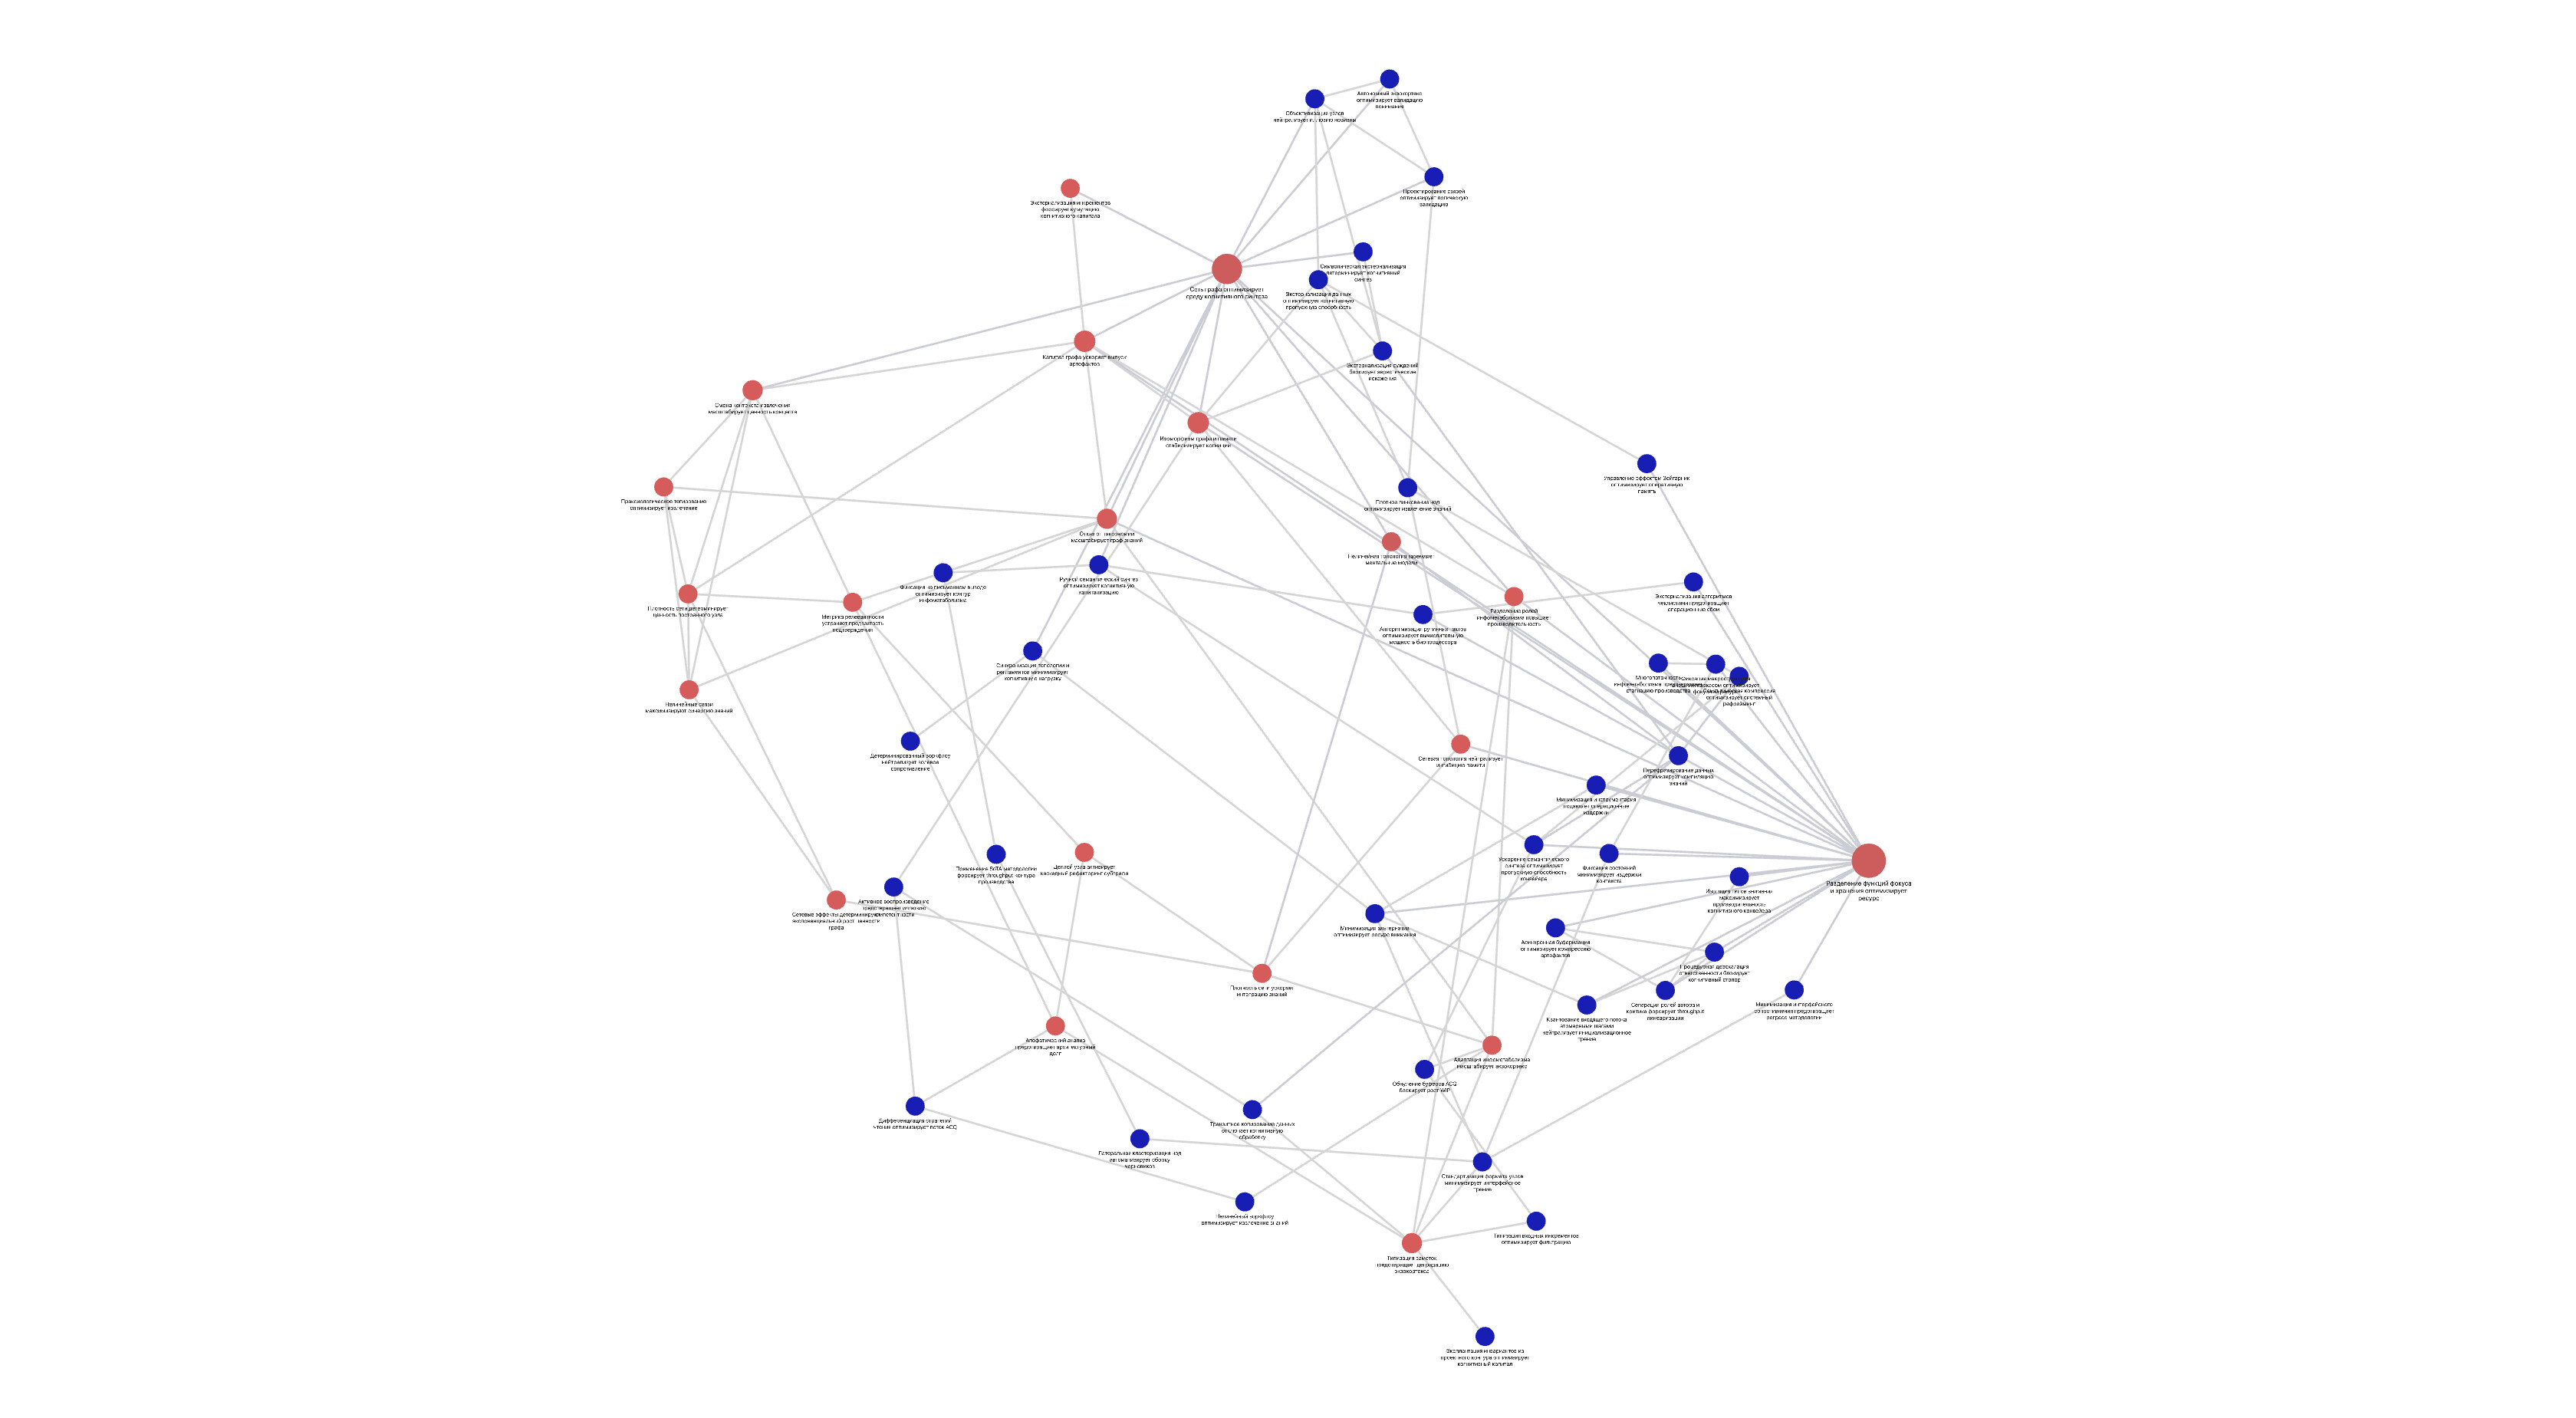
- Если свести метод Лумана к пяти ключевым тезисам, чтобы объяснить, в чём его суть и почему он работает, это будут следующие тезисы (вытекающие из двух фундаментальных когнитивных свойств биологического мозга - малой памяти и стремлении экономить энергию где можно):
- разделение функций фокуса и хранения между мозгом и экзокортексом, так как мозг обладает малой оперативкой и неспособен одновременно быть и процессором, и хранилищем, и надо хранилище делегировать внешнему носителю, чтобы процессор заработал на полную мощность;
- мышление возможно только в акте письма. Письмо есть не результат мышления, а само мышление. Не пишешь - не думаешь;
- разделение труда и оптимизация воркфлоу. Правильный порядок заменяет внутренний саботаж желанием делать несложные и понятные действия ежедневно, которые удивительным образом повышают производительность труда и дают дофаминовое подкрепление в долгосроке;
- атомарность стандартизированных узлов (заметок);
- отказ от top-down иерархической классификации по темам в пользу bottom-up сетевой топологии графа, который обладает эмерджентностью и только упрощает работу при росте числа нод. В нём всё связано со всем нестандартным и зачастую гораздо более продуктивным образом, чем в традиционных системах.
- Если расширить метод Лумана до семи тезисов, это будут следующие:
- разделение функций фокуса и хранения;
- мышление как процесс экстернализации (письма);
- атомарность узлов;
- оптимизация вокфлоу за счёт разделения труда;
- сетевая топология вместо жёсткой иерархии;
- минимизация альтернатив в рабочей среде;
- непрерывный компрессионный рефакторинг базы знаний (семантическое сжатие и топологический аудит, устраняющие архитектурный долг системы).
- Десять тезисов, описывающих систему Лумана, будут следующие:
- разделение функций фокуса и хранения;
- мышление как процесс экстернализации мыслей письмом;
- атомарность информационных узлов;
- сетевая топология вместо жёсткой иерархии;
- оптимизация воркфлоу против принуждения за счёт разделения труда;
- минимизация альтернатив в рабочей среде;
- стандартизация формата и интерфейсов;
- эксплантация инвариантов из проектных контуров;
- ориентация всего инфометаболизма на производство готовых письменных артефактов, что переводит его из just in case в just in time (“Какой текстовый продукт я собираюсь отчуЖдить в мир, для чего мне нужно потребить вот этот новый кусок информации? Никакой? Отлично - его потребление запрещено, процесс блокируется, так как зафиксирована попытка нарушить продуктовую ориентацию и повысить энтропию агента”);
- непрерывный компрессионный рефакторинг базы знаний.
-
Как LLM обосновывает, почему созданный с её помощью контур моего инфометаболизма является SoTA? Потому что он решает фундаментальную кибернетическую задачу - преодоление аппаратных ограничений биологического носителя (RAM, TPN, confirmation bias, active inhibition) за счёт создания строго типизированной, ИИ-верифицируемой, нелинейной распределённой среды вычислений, ориентированной на капитализацию знаний и скорость выпуска конечных артефактов. ИИ интегрировал в метод Лумана layered architeture, топологию DAG, когнитивные науки (Каннеман, desired diffuculties, TPN/DMN модель), TOC & Lean Management.
-
“Медленного дофамина” не существует, физиологически он всегда быстрый. Для использования механики “быстрого дофамина” в объективно энергозатратном за счёт Системы 2 контуре инфометаболизма output-driven, я должен выйти на режим ежедневного создания трёх постоянных нод L3/L4, дающих визуальный прирост графа в Обсидиан, с обнулением буферов ACQ к концу дня (необработанных заметок нет), фокусировка на синтезе не должна быть более 4-х часов в сутки суммарно (остальное время - работа на дешёвых мощностях, DMN или техобслуживание). Я должен видеть физический прирост своего когнитивного капитала в реальном времени ежедневно (количество нод, динамическая плотность графа, автоматическое появление ноды в дашбордах). SoTA-метод управления инфометаболизмом требует инструментального обхода/обмана дофаминового контура, с помощью которого тяжёлый медленный энергозатратный, но снижающий энтропию в итоге just-in-time процесс производства инкремента в мире превращается в цепочку быстрых атомарных шагов, которые легко совершать и которые обладают дофаминовым подкреплением. Дофамин остаётся быстрым, но генерируется не фактами поглощения инфошума, не ведущими к созданию инкрементов, а только к росту зашлакованности мозга обывателя, а фактами завершения атомарных шагов - производства инвариантов, приращающих когнитивный капитал ежедневно. Сам процесс перехода в более термодинамически выгодное, низкоэнтропийное состояние JIT требует затрат энергии на переход, так как активируется Система 2, которая работает на время перехода и в самих тактах синтеза. У меня сейчас как раз этот переход. Поэтому нужно отдыхать чаще. Потребление информации может быть либо JIT, либо никакого.
-
Деятель - открытая система, упорядочивающая (снижающая энтропию) во внешней среде. Поэтому фаза PROD - включая тексты - для него становится математически и инженерно обязательной. Ведь деятель поглощает из мира информацию и энергию, которые использует для изменения мира (создания целевых систем) и изменения себя как системы создания (тела/личности/экзокортекса). Выпуск текстового артефакта в мир - это наложение на внешнюю систему информационного ограничения. Те агенты, которые прочитают и внедрят знания из данного артефакта - а они неизбежно будут - перестроят свои прикладные методы действия. Их поведение станет более детерминированным и упорядоченным. Энтропия внешней по отношению к деятелю среды упадёт. Выпуск текстовых артефактов - это инструмент собственно снижения энтропии внешней среды деятелем, его функция. Его не может не быть, или быть опционально. Если есть изменение мира - есть выпуск текстовых артефактов. Вот эту мысль мне непросто понять. Но проще понять через наложение информационного ограничения на мир текстовым артефактом. Не нравится тебе некоторое поведение - наложи на него хотя бы информационное ограничение, это то, что тебе никто не может запретить. И далее делай это регулярно и постоянно, и изменение мира произойдёт. Текстовый артефакт, отчуждённый в мир - это единственный интерфейс совместимости деятеля/его экзокортекса с физической реальностью. В SoTA-контуре инфометаболизма PROD - это промышленный сброс давления в системе. Это обязательный такт развёртывания скомпилированного семантического кода в физический мир для принудительного изменения его параметров деятелем (достаточно простого, надо сказать - менять мир созданием текстовых артефактов). Если деплоя/развёртывания нет, весь конвейер инфометаболизма работает вхолостую.
-
Поскольку обязано быть сочетание exploration/exploitation, его в контексте поглощения ACQ обслуживают два метода чтения - архитектурное и инструментальное:
- первое отвечает за изменение архитектуры деятеля как системы создания, набора его фундаментальных методов мышления, меняющих прикладные. Это JIT, но замаскированный, похожий на JIC. Оно завершается созданием одной постоянной макро-ноды по целой книге. Эквивалентно капитальным затратам (время закладывается в бюджет и расходуется по принципу Timeboxing, но немедленной отдачи нет и быть не может, зато система не генерирует архитектурный долг, предотвращая моральное устаревание всей системы за счёт активации Системы 2 на территории неизведанного пространства). Продуктом чтения является прирост когнитивного капитала в графе знаний, а также изменение архитектуры деятеля, спецификаций его контекстов. Поскольку макро-нода постоянная одна, исключается взрывной рост wip из-за количества заметок;
- второе отвечает за внедрение текущих инкрементов во внешнем мире (создание целевых систем) на текущей архитектуре деятеля (которую не затрагивает). Это “чистый JIT”, который не может занимать 100% времени, иначе архитектурный долг гарантирован. Работает по pull-принципу от активных задач, жёстко лимитирован по WIP. Сюда могут быть отнесены тексты и инкременты в целевых системах. Поскольку оно направлено на производство конкретных инкрементов здесь и сейчас, оно обладает высокой селективностью и завершается генерацией необходимого минимума постоянных нод даже при высокой плотности источника (потребляется только то, что нужно).
В итоге, какой бы метод чтения мы не использовали, количество wip под контролем, процесс не растягивается во времени, так как подчинён разным целям, у каждой из которой работает свой ограничитель wip (timeboxing и одна нода на книгу; только нужные ноды под запрос).